 Connexion


Depuis que X a shooté Nitter et XCancel à grands coups de lettres d'avocat fin août, lire X sans compte c'est redevenu une méga galère. Mais il reste pourtant un outil que plein de gens utilisent sans le savoir, parce qu'il tourne dans les coulisses de Discord et Telegram. Son nom ?
FxTwitter !À la base, le projet FxEmbed , qui fait tourner FxTwitter et FixupX, sert à réparer les aperçus de liens X. Vous mettez fx devant twitter.com (ou fixup devant x.com) et Discord affiche enfin la vidéo, le sondage ou toutes les images du post. Sauf que derrière, il y a surtout une API publique et gratuite, api.fxtwitter.com, qui affiche n'importe quel post public en JSON sans avoir besoin de compte ou de clé API facturé une couille. Ché Elon !
Alors oui, les rageux diront que x.com affiche encore n'importe quel post isolé à un visiteur déconnecté, même les longs, mais sur un profil, ça s'arrête à 5 posts avant de vous demander de "Continuer sur X". Et surtout, ça ne vous affichera pas les vidéos et ça ne vous permettra pas d'avoir ça sous la forme d'un flux RSS.
Alors que FxTwitter, lui, nous sort tout ça sans avoir à ouvrir x.com !
Maintenant pour nos tests, prenons un vieux de la vieille, un vétéran, le post numéro 20 de @jack, publié le 21 mars 2006 et dont l'URL est x.com/jack/status/20. Le nombre à la fin, c'est l'identifiant du post.

Collez tout simplement cet identifiant au cul de api.fxtwitter.com/2/status/ et ouvrez ça dans votre navigateur :
https://api.fxtwitter.com/2/status/20
Et vous obtiendrez un gros pavé en JSON avec dedans le texte du post dans le champ "text", l'auteur dans "author", et un peu plus bas vous trouvez les likes, les reposts, les réponses et la date.
Le post 20 de @jack vu par l'API : le texte dans le champ text, l'auteur juste en dessous.
Et si vous avez la flemme de recopier l'identifiant (vous êtes toujours dans l'abus, vous ^^), remplacez simplement x.com par api.fxtwitter.com dans l'adresse complète du post et voilà ! Ça marche à tous les coups, même si c'est le retour de l'ancienne version de l'API, conservée pour la compatibilité.
Pour utiliser ça avec un script, je vous conseille d'utiliser curl pour faire la requête et jq pour trier tout ça ( jq, c'est le petit utilitaire qui extrait un champ précis d'un JSON ).
Ainsi, pour n'afficher que le texte du post :
curl -s "https://api.fxtwitter.com/2/status/20" | jq -r '.status.text'
Et si le post n'est pas en français, ajoutez ?lang=fr à l'adresse et hop, magie magie, l'API glisse alors un bloc "translation" dans la réponse, avec le texte en français :
curl -s "https://api.fxtwitter.com/2/status/20?lang=fr" | jq -r '.status.translation.text'
Le texte d'origine du post 20, puis sa traduction demandée avec ?lang=fr.
La traduction provient de X lui-même quand elle existe (sur ce post, le champ "provider" indiquait "grok"), sinon l'API se rabat avec joie sur un service de traduction. Et pour un profil, c'est le même principe avec /2/profile/ : api.fxtwitter.com/2/profile/jack qui affichera la bio de @jack, son nombre d'abonnés et sa date d'inscription. Les autres "routes" qui récupèrent les fils, les abonnés ou les médias d'un compte sont dans la documentation de l'API .
Elle est pas belle la vie ?
Maintenant, on va rentrer dans le dur parce qu'ici, pour récupérer une vidéo, vous n'avez pas besoin d'API. Suffit de jouer avec l'adresse.
Mettez d. devant fxtwitter.com et le lien vous renverra directement le fichier, sans HTML autour. Avec curl, ça donne ça (le -L sert à suivre la redirection) :
curl -L -o video.mp4 "https://d.fxtwitter.com/NASA/status/2102748685792596449"
Grâce à ça, on peut par exemple récupérer le MP4 de cette vidéo bien kitchou de 30 secondes de la NASA. Et ajouter .mp4 à la fin d'une adresse fxtwitter.com fera la même chose. Et pour choisir la qualité, jetez un œil au JSON du post, où la liste des formats de media.videos donne chaque version de la vidéo avec son adresse et son bitrate.
Dernier truc que je trouve pratique avec cet outil c'est que chaque compte public peut avoir son flux RSS. Il suffit d'ajouter /feed.xml après le nom du compte :
https://fxtwitter.com/korben/feed.xml
Collez ensuite ça dans votre lecteur RSS et vous suivrez le compte X de vos rêves sans avoir à y mettre les pieds. Le flux remonte ainsi les 90 derniers posts par défaut, et le paramètre ?count= permet de réduire ce nombre ou de l'augmenter jusqu'à 100 maximum. Et si vous remplacez feed.xml par media.xml vous ne verrez dans le flux que les posts contenant des photos ou des vidéos. Et si vous ajoutez ?with_replies=1 vous verrez aussi les réponses.
Maintenant ce qui peut être relou, c'est que l'API n'encaisse que 1 000 requêtes par minute et par adresse IP. Par contre, si vous pensiez absorber tout x.com sans la moindre vergogne, vous allez vite vous retrouver coincé.
Attention aussi au domaine que vous tapez. Les seuls officiels sont fxtwitter.com, twittpr.com, fixupx.com, xfixup.com et fxbsky.app pour Bluesky. Je précise ça parce qu'il y a eu, par exemple un fxtwiter.com avec un t en moins, qui a été signalé sur le dépôt du projet et qui renvoyait les gens vers des arnaques.
Comme d'hab, une faute de frappe et c'est le drame... Soyez très vigilants.
Maintenant, si vous êtes un petit peu curieux comme moi, vous vous êtes sûrement demandé comment FxTwitter récupérait tout ça ??
Eh bien, comme le fait Nitter, ou plutôt comme le faisait Nitter , il récupère les données en utilisant de vrais comptes X sur lesquels il répartit les requêtes. Et comme c'est ce qui a été reproché à Nitter, je me dis qu'il y a des chances qu'à un moment FxEmbed soit visé aussi.
On verra bien, mais si un jour le service tombe, sachez que le code est bien dispo sous licence MIT, donc vous pouvez le faire tourner chez vous sans problème dans un Docker. Et si vous n'utilisez pas de compte X connecté dessus, ça marchera quand même avec, c'est vrai, des limites de requêtes plus basses et surtout sans accès au contenu NSFW (Et ça, je sais que ça vous rend super triste.)
Source : GitHub
This week the post office delivered a package that made me very satisfied. It was a box with three paper versions of my "Web Development with Django Cookbook - Second Edition". The book was published at the end of January after months of hard, but fulfilling work in the late evenings and at weekends.
The first Django Cookbook was dealing with Django 1.6. Unfortunately, the support for that version is over. So it made sense to write an update for a newer Django version. The second edition was adapted for Django 1.8 which has a long-term support until April 2018 or later. This edition introduces new features added to Django 1.7 and Django 1.8, such as database migrations, QuerySet expressions, or System Check Framework. Most concepts in this new book should also be working with Django 1.9.
My top 5 favourite new recipes are these:
The book is worth reading for any Django developer, but will be best understood by those who already know the basics of web development with Django. You can learn more about the book and buy it at the Packt website or Amazon.
I thank the Packt Publishing very much for long cooperation in the development of this book. I am especially thankful to acquisition editor Nadeem N. Bagban, content development editors Arwa Manasawala and Sumeet Sawant, and technical editor Bharat Patil. Also I am grateful for insightful feedback from the reviewer Jake Kronika.
What 5 recipes do you find the most useful?
The Reddit users among you may already be aware of the Shower Thoughts subreddit. For those of you who aren’t, Shower Thoughts is where people go to post the random epiphanies they’ve had about life, the universe, and everything. For example:
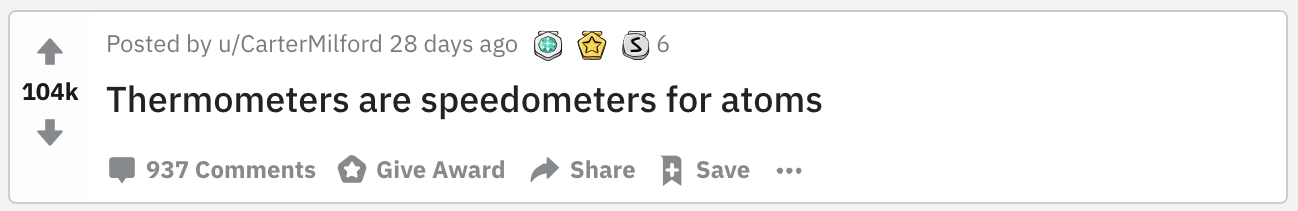
YouTuber ACROBOTIC is a fan of the Shower Thoughts subreddit. So much so that they decided to program their Raspberry Pi to update an e-paper HAT with the subreddit’s top posts from the last hour.
Raspberry Pi 4 Scrape JSON Data w/ Python And Display It On e-Paper | reddit /r/showerthoughts
$2 for PCB prototype (any color): https://jlcpcb.com/ ========== * Your support helps me post videos more frequently: https://www.patreon.com/acrobotic https://www.paypal.me/acrobotic https://buymeacoff.ee/acrobotic BTC: 1ZpLvgETofMuzCaKoq5XJZKSwe5UNkwLM ========== * Find me on: https://twitter.com/acrobotic https://facebook.com/acrobotic https://instagram.com/acrobotic ========== * Parts & supplies: https://acrobotic.com/shop https://amazon.com/shops/acrobotic ========== In another video we setup a Raspberry Pi to control an e-Paper/e-Ink HAT and running demo code.
For their build, they used a three-colour e-paper display, but you can use any e-paper add-on for Raspberry Pi to recreate the project. They also used Raspberry Pi 4, but again, this project will work with other models — even Raspberry Pi Zero W.
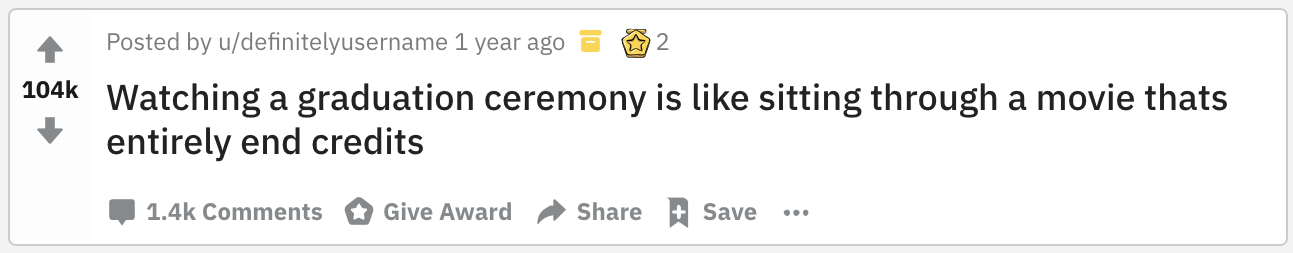 ACROBOTIC created an image to frame the Shower Thoughts posts, which they uploaded to their Raspberry Pi as a .bmp file. They altered prewritten code for using the e-paper display to display this frame image and the various posts.
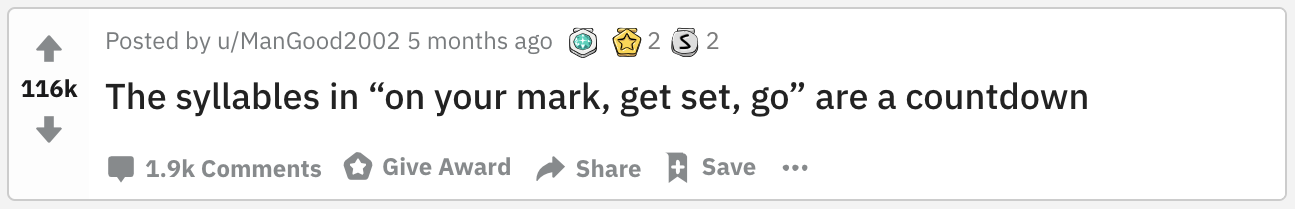 Adding
.json to the URL of the appropriate Shower Thoughts page allows access to the posts in JSON format. Then a request can be set up to pull the data from this URL.
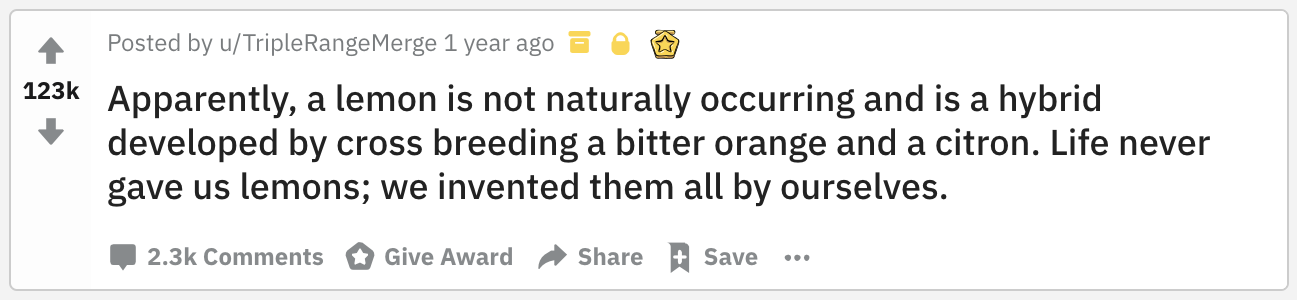 ACROBOTIC goes into far more detail in their video, and it’s a great resource if you’re looking to try out working with JSON files or to learn how to pull data from Reddit.
Find more projects using e-paper displays for you to recreate in our handy guide.
The post Pulling shower thoughts from Reddit for a Raspberry Pi e-paper display appeared first on Raspberry Pi.


 Lateo.net - Flux RSS en pagaille (pour en ajouter : @ moi)
