 Connexion


Hubert, fidèle lecteur de Korben.info m'a envoyé un mail pour me dire qu'il avait reçu sa nouvelle carte d'identité. Vous savez celle en petit format avec la puce dedans qu'on peut scanner avec l'app France Identité. Et il en est bien content !
Voilà, l'histoire s'arrête là !
Mais non, je plaisante ! En fait, Hubert s'est posé LA question que personne ne se pose à l'heure de l' identité numérique européenne : Y'a quoi là dedans ?
Et plutôt que d'attendre qu'un employé de mairie expert en technologie ne lui explique (j'rigole, ça n'existe pas), il a passé son week-end à coder cnie-python-tools , un projet codé en python (vous aviez deviné je pense) capable de lire la puce de la CNI et de vous ressortir les infos y compris la photo d'identité.
Le tout sous Linux, évidemment, sans smartphone ni app officielle.
Pour l'utiliser, vous devez brancher un lecteur de carte à contact (un
ACR38U
, un
Omnikey
(liens affiliés), ce genre de bestiole compatible PC/SC), vous lancez uv run cnie-dump, et vous tapez le CAN, c'est-à-dire les 6 chiffres imprimés au recto de votre carte.
Photo envoyée par Hubert, je me suis permis d'enlever ses données personnelles #RGPD-way-of-life ^^
Y'a besoin de cette clé car c'est elle qui permet de déverrouiller la puce via un protocole qui s'appelle PACE. C'est ce mécanisme précis qu'utilise la carte France Identité quand elle lit votre carte en NFC sauf que là c'est direct sur votre PC. Son script permet alors de récupérer toutes les data dans des fichiers bruts + un summary.json qui liste tout ce que la carte a bien voulu cracher.
Et c'est qu'elle est bavarde cette coquine, puisqu'avec ce simple script, elle vous sort votre état civil complet (nom, prénoms, date et lieu de naissance, nationalité), votre adresse, votre taille, la MRZ (la fameuse bande de caractères qu'on retrouve aussi sur les passeports), mais aussi la photo qui est dessus au format JPEG 2000, un format parfois un peu pénible à ouvrir.
Bref, de quoi remplir un formulaire administratif sans avoir à tout retaper.
Maintenant rassurez-vous, il y a quand même des données qu'on ne peut pas extraire. Sur la CNIe française, la donnée biométrique sensible, ce sont vos deux empreintes digitales (DG3), et celles-là restent bouclées à double tour derrière l'EAC, une couche de sécurité réservée aux terminaux officiels de l'État. Quand le script tape à cette porte, la carte répond aussi sèchement qu'un agent assermenté sans clim, avec le code 6982, ce qui veut dire "security status not satisfied", cause toujours.
Si ça vous dit d'essayer bien sûr, c'est à utiliser uniquement avec votre propre carte. Et si le lecteur sur la photo ci-dessus vous parle, c'est normal. Plutôt que d'acheter un lecteur de carte tout neuf, Hubert a simplement réalisé ses tests avec le lecteur fourni par les TCL (le réseau de transport Lyonnais) qui visiblement est dans le tur-fu en ce qui concerne la recharge des abonnements de métro ^^.
Merci Hubert pour le partage !!
Swift, le langage maison qu'Apple a sorti en 2014 pour remplacer le vieillissant Objective-C, vient de débarquer sur une machine qui a quarante-neuf ans de plus que lui. Yeo Kheng Meng, un bidouilleur basé à Singapour, a restauré un Apple II Plus puis s'est demandé jusqu'où il pouvait pousser ce vieux tromblon, ce qui a donné SwiftII, un petit environnement Swift qui tourne aussi bien sur l'Apple II d'origine de 1977 que sur les IIe qui ont suivi.
Le défi donne le vertige quand on connaît la bête. L'Apple II carburait à un processeur 6502 cadencé à 1 MHz avec 4 Ko de mémoire à sa sortie, là où Swift a été pensé pour des machines des milliards de fois plus puissantes, et il a fallu pousser la RAM à 48 Ko pour espérer y faire tenir quoi que ce soit.
Plutôt que de traduire directement le code en instructions 6502, Yeo a repris une idée qu'Apple avait déjà eue en 1979 avec son Apple Pascal, qui consistait à compiler le programme en bytecode, c'est-à-dire un code intermédiaire générique, avant de l'exécuter dans une machine virtuelle, une sorte de processeur simulé en logiciel par-dessus le vrai. Presque un demi-siècle d'écart, et la même astuce pour contourner les limites du 6502.
Le pipeline reste volontairement minimaliste pour grappiller chaque octet, puisque le code source passe dans un analyseur, puis un parser qui crache directement le bytecode sans construire d'arbre intermédiaire, le tout avalé par une petite machine virtuelle à pile largement inspirée du livre Crafting Interpreters de Robert Nystrom.
Forcément, ce Swift-là est une version croupion. Il n'existe qu'un seul type de nombre, l'entier signé sur 16 bits, donc rien au-delà de -32 768 à 32 767, et surtout aucun nombre à virgule vu que le 6502 n'a pas de quoi calculer ça. Les chaînes de caractères sont du pur ASCII, les noms de variables plafonnent à onze caractères, et exit les closures, dictionnaires, gestion d'erreurs et autres async/await.
Côté ce qui marche quand même, on récupère les let et var avec inférence de type, les conditions, les boucles, les fonctions, les optionnels, les tableaux et même l'interpolation de chaînes, de quoi écrire de vrais petits programmes. Le projet embarque d'ailleurs un jeu de motos lumineuses et quelques démos graphiques qui tournent pour de bon sur le matériel d'époque.
La contrainte la plus délicate reste la mémoire, parce qu'une fois ProDOS chargé il ne reste qu'environ 40 000 octets pour votre programme, et comme le 6502 ne sait pas adresser davantage, il faut jongler avec des banques de mémoire commutées comme à la grande époque.
Le tout est écrit en C90, compilé avec cc65, et distribué en neuf images disque différentes selon les machines visées. Détail savoureux, Yeo a bouclé ce chantier en deux mois avec l'aide de Claude Opus 4.8 et de Codex, là où il estime que seul, ça lui aurait coûté deux à trois ans de travail.
Du coup, on a un langage de 2014 qui cause à une puce de 1977 grâce à une recette de 1979. C'est parfaitement inutile, et c'est exactement pour ça que c'est chouette.
Source : Hackaday
Jean-Marc Biechy est prof d'électronique et d'informatique à l'Institution Saint-Jean de Colmar et il vient de m'envoyer un truc qui m'a scotché. Avec ses élèves, il bidouille des projets Arduino, et plutôt que d'empiler des bouts de code à chaque nouveau montage, il a fait un choix un peu fou : écrire son propre système d'exploitation en partant de zéro pour un microcontrôleur.
Ça s'appelle IoToS, pour Internet of Things micro Operating System, et ça transforme un Arduino UNO R4 ou un ESP32/8266 en vrai petit nœud réseau avec un accès en ligne de commande qui ressemble vachement à du bon vieux terminal Linux.
Vous branchez la carte, vous ouvrez un terminal série (ou un Telnet sur le port 23), et là vous tapez des commandes comme ping, tracert, netstat, dir, ip ou dhcp on tout ça directement sur Arduino.
Ce qui est chouette avec son approche c'est qu'elle est pédagogique car un Arduino tout nu, c'est un automate avec un setup() qui s'exécute une fois, une loop() qui tourne en boucle à l'infini, et basta.
Et à l'autre bout du spectre, vous avez de vrais OS temps réel (RTOS), souvent trop gros ou trop austères pour intéresser un élève de Bac Pro. Et entre les deux, y'avait rien qui faisait vraiment le pont entre l'automate et un vrai petit OS avec sa ligne de commande.
Jean-Marc a donc créé ce chaînon manquant en découpant son code exactement comme un OS. Un Boot Firmware avant le setup, un Load Driver qui gère la connexion réseau et l'écran, un Kernel qui n'est autre que la loop(), un CLI dans un fichier shell_Cmdline.h, et des applis par-dessus.
La bestiole embarque donc un serveur web AJAX qui sert des pages HTML depuis une carte MicroSD, un serveur FTP pour balader les fichiers via FileZilla, une synchro NTP et un datalogger CSV horodaté. Le tout sur un noyau coopératif, sans RTOS, le code métier de votre projet étant compilé dans le même firmware.
Et c'est là qu'on mesure le boulot d'orfèvre puisque ce firmware complet tient dans 142 Ko, soit 54% de la flash de l'UNO R4, et il reste près de 19 Ko de RAM libre sur les 32. Caser un shell réseau, un serveur web et du FTP là-dedans sans tout faire planter, c'est pas donné à tout le monde, le mec est doué !
Et avec cette base, ses élèves montent des prises IP commandables au navigateur, une caméra de surveillance sur LilyGo déclenchée par un détecteur de mouvement, une station météo consultable en ligne, une alarme PIR qui envoie un mail, de la gestion de chauffage à distance, ou du pilotage de LED RVB et de projecteurs DMX par Ethernet.
La prise IP sert d'ailleurs de système minimal de référence, et le reste, vous pouvez l'étendre en ajoutant vos propres commandes CLI et vos pages web dans les fichiers .h prévus pour.
Jean-Marc raconte y avoir passé environ 2000 heures de code et de tests, juste pour voir si c'était possible d'en écrire un tout seul. Il est parti de bibliothèques existantes (LittleFS, ping, FTP, dir) qu'il a patiemment fait discuter ensemble... Faut dire que recoder un OS de zéro pour le plaisir d'apprendre , c'est un sport à part entière et malheureusement, trop peu de gens d'y essayent.
Son code source est commenté et distribué librement sous licence GNU LGPL v2.1, donc réutilisable y compris pour un usage commercial. Tout est à télécharger sur le site du projet , avec la doc PDF, les vidéos de démo et la liste complète des commandes.
Si vous avez un Arduino R4 qui prend la poussière, vous savez maintenant quoi en faire ! Bravo Jean-Marc !!
Et si le secret d’une bonne IA de programmation était de devenir moins productive ? C’est le pari insolite de Ponytail, un projet open source qui force les assistants de code à imiter les développeurs seniors les plus pragmatiques pour éviter la sur-ingénierie et réduire la facture.
Vingt et un ans après sa création par Linus Torvalds, Git amorce pour de bon son changement de langage. La première version de test de Git 2.55, publiée hier, active par défaut le code Rust dans le gestionnaire de versions le plus utilisé au monde, celui qui héberge l'historique d'à peu près tous les projets logiciels de la planète.
Jusqu'ici, il fallait réclamer explicitement le Rust au moment de compiler le logiciel, c'est-à-dire de le fabriquer à partir de son code source, via une option baptisée WITH_RUST ou via le système de build Meson. Git 2.55 inverse la logique : le Rust est désormais supposé présent, et c'est pour s'en passer qu'il faut lever la main, avec une nouvelle option NO_RUST.
Pour situer, Rust est un langage de programmation conçu pour éliminer toute une famille de bugs mémoire, ceux-là mêmes qui font le bonheur des pirates depuis quarante ans. Git, lui, est écrit en C depuis 2005, un langage qui laisse au développeur l'entière responsabilité de ne pas se tirer une balle dans le pied.
Le chantier ne date pas d'hier. L'an dernier, Patrick Steinhardt, un des mainteneurs du projet, proposait d'introduire Rust dans le cœur de Git et d'en faire à terme une dépendance obligatoire pour fabriquer l'outil.
Git 2.52 avait franchi le premier pas fin 2025 en convertissant un petit module, varint.c, chargé de décoder des entiers à taille variable. Du code volontairement modeste : l'idée était de roder la chaîne de compilation, pas de réécrire Git.
Avec la 2.55, le rythme change. L'équipe prépare d'ailleurs le portage de xdiff, le moteur qui calcule les différences entre deux versions d'un fichier, autrement dit le cœur du métier de Git.
Et le calendrier est déjà là : à partir de Git 3.0, Rust sera obligatoire, sans aucune possibilité de le désactiver. Aucune échappatoire. L'option NO_RUST de la 2.55 n'est donc qu'un sursis.
Pour vous, rien ne change : les binaires fournis par votre distribution Linux, par Apple ou par GitHub arrivent déjà compilés. Ce sont les empaqueteurs et les plateformes un peu spéciales qui vont devoir installer la chaîne d'outils Rust.
Sauf que voilà, tout le monde n'a pas un compilateur Rust sous la main. La proposition de Steinhardt avait déclenché de longs débats autour des plateformes exotiques, comme les serveurs NonStop de HPE ou certains vieux Unix, où Rust ne tourne tout simplement pas aujourd'hui. Le projet compte sur les progrès de gccrs, le support Rust en cours d'intégration dans GCC, le compilateur historique du monde libre, pour boucher ces trous avant l'échéance.
Le reste de la version est plus classique, avec des optimisations, des corrections de bugs et de petites améliorations sur différentes sous-commandes, détaillées dans l'annonce de Junio Hamano, le mainteneur en chef du projet.
Voir Git, monument du C, basculer sur Rust par défaut, c'est le signe le plus clair que le vieux langage perd du terrain.
Source : Phoronix
Faire tourner Tetris sur un émulateur Game Boy dont le code source tient dans moins de 5 ko de C volontairement incompréhensible, voilà le genre de prouesse que célèbre l'IOCCC, le concours international de code C obfusqué, dont le palmarès 2025 mérite vraiment le détour.
Le principe de ce concours créé en 1984 n'a pas bougé : écrire un programme en C (un des plus vieux langages de programmation encore massivement utilisés) qui fonctionne parfaitement, mais dont le code est si tordu que personne ne comprend comment. L'obfuscation, c'est exactement ça : rendre un code illisible. Ici, on le fait exprès, pour la beauté du geste.
Les règles posent quand même un cadre strict : 4993 octets de code source maximum, du C conforme au standard C11, un Makefile au format GNU (le fichier qui explique comment compiler le programme), et une consigne officielle qui interdit de transformer l'ordinateur des juges en brasier.
Après une pause entamée en 2020, cette 29e édition a battu des records de participation. Les juges ont retenu 23 programmes gagnants, dévoilés lors d'une cérémonie diffusée en direct pendant plus de quatre heures, avec au passage un premier lauréat venu de Taïwan, une grande première pour le concours.
Trois participants signent un triplé, avec trois programmes primés chacun : Yusuke Endoh, Don Yang et Nick Craig-Wood. Ce dernier, qui est aussi l'auteur de rclone (l'outil de synchronisation de fichiers bien connu des bidouilleurs), repart avec le prix du meilleur émulateur réel pour sa Game Boy logicielle réduite à l'os, un programme qui imite la console de Nintendo au point de faire tourner les fichiers des vraies cartouches, Tetris compris, sans le son ni la moindre fioriture.
Yusuke Endoh décroche de son côté le prix du programme "le plus susceptible de choquer", jeu de mots électrique assumé : son code dessine dans le terminal des figures de Lichtenberg, ces arborescences que trace une décharge électrique dans un matériau, uniquement avec des caractères de texte. Le résultat est superbe.
Le reste du palmarès part dans tous les sens. On y trouve une machine virtuelle qui émule un processeur imaginaire à une seule instruction, une carte perforée façon trou noir, un quasi-rogue-like (ces jeux d'exploration de donjons générés aléatoirement) et un quine, ce programme dont la sortie est son propre code source.
Petit détail d'histoire pour finir : obfusquer du code a longtemps servi à distribuer des logiciels propriétaires sur les systèmes UNIX sans en livrer les secrets. C'est devenu depuis un art à part entière.
Tout le palmarès est consultable sur ioccc.org , code source compris. Vous pouvez d'ailleurs récupérer les programmes et les compiler chez vous, histoire de vérifier que ces horreurs fonctionnent vraiment.
Bref, pendant que la planète entière demande à des IA de pondre du code propre, eux s'acharnent à écrire l'inverse à la main. J'adore.
Source : Hackaday
Le conseil de pilotage de Python, l'instance qui tranche les grandes décisions du langage, a demandé le 5 juin la suspension de tout nouveau développement sur son compilateur JIT.
Un JIT (just-in-time), c'est un compilateur à la volée : au lieu d'interpréter votre code ligne par ligne, il traduit les portions les plus sollicitées en instructions machine pendant l'exécution, histoire de gagner en vitesse. Python en a un, expérimental, depuis la version 3.13 sortie début 2024.
Le problème n'est pas le code. Il est dans la procédure.
Ce JIT est arrivé dans la branche principale de CPython, l'implémentation de référence du langage, sans passer par le circuit de décision habituel. Chez Python, toute évolution majeure doit faire l'objet d'un PEP, un document formel que la communauté discute puis valide. Celui qui couvre le JIT, le PEP 744 signé Brandt Bucher et Savannah Ostrowski, n'est qu'informatif et laisse plusieurs questions en suspens : la maintenance future, la compatibilité avec l'outillage existant, les critères de réussite mesurables.
Le conseil l'a reconnu noir sur blanc : il n'a pas été "aussi strict sur le respect du processus qu'un changement de cette ampleur le méritait". Responsabilité partagée, donc.
En pratique, plus aucune nouvelle fonctionnalité JIT ne peut atterrir sur la branche principale tant qu'un PEP en bonne et due forme n'est pas accepté. Les corrections de bugs et de sécurité, elles, continuent. Le conseil laisse une fenêtre de six mois pour soumettre et faire valider ce document. Passé ce délai, faute d'accord, le code du JIT sera purement et simplement retiré.
Le timing est mauvais. Le JIT amélioré était l'une des nouveautés mises en avant de Python 3.15, dont les fonctionnalités sont déjà gelées et dont la sortie est attendue en octobre. Sur du x86-64 sous Linux, il promet un gain de 8 à 9% en moyenne, même s'il reste désactivé par défaut et consomme 10 à 20% de mémoire en plus.
Mark Shannon, un des principaux contributeurs, n'a pas caché son agacement. Pour lui, tout arrêter d'un coup fait perdre l'élan et risque de faire fuir les nouveaux venus, alors il réclame une période de grâce pour avancer pendant que le PEP se construit. Barry Warsaw, lui, a demandé pourquoi le travail ne pourrait pas se poursuivre dans un dépôt séparé le temps des discussions.
La réponse du conseil tient en une idée : mettre le développement en pause évite que le JIT devienne une cible mouvante pendant qu'on débat de son sort.
Du coup, on se retrouve avec une techno qui fonctionne, déjà embarquée dans le langage, suspendue à un document qui n'existe pas encore.
Geler une techno qui marche pour une procédure oubliée, c'est agaçant sur le moment. Mais sur un langage utilisé par des millions de gens, c'est probablement plus prudent.
Source : The Register
Un développeur connu sous le pseudonyme icitry s'est posé une question que personne de sensé ne formule jamais, peut-on coder un jeu de tir à la première personne en COBOL ? La réponse, contre toute attente, est oui, et le résultat est même tout à fait jouable.
Pour ceux que ce nom laisse de marbre, COBOL, pour Common Business Oriented Language, est un langage né en 1959 qui fait encore tourner aujourd'hui une partie des mainframes chargés de vos virements bancaires et de la paie. C'est l'outil de la gestion et des relevés de compte, à peu près l'inverse de ce qu'on imagine pour un jeu vidéo.
Le moteur du jeu repose sur le raycasting, cette technique qui a propulsé Wolfenstein 3D au début des années 90. Le programme projette une rangée de rayons depuis le point de vue du joueur, regarde où chacun vient percuter un mur, et en déduit colonne par colonne la hauteur à dessiner. De la fausse 3D reconstruite à partir d'un simple plan vu de dessus.
Le vrai casse-tête, c'est que COBOL n'embarque aucune bibliothèque graphique, pas la moindre fonction pour allumer un pixel ou ouvrir une fenêtre. La parade est astucieuse. Le programme calcule lui-même chaque image, en recrache les pixels bruts sur la sortie standard du terminal, puis laisse un petit utilitaire nommé ffplay récupérer ce flux pour l'afficher comme une vidéo animée.
Même esprit de débrouille pour les commandes. Le terminal bascule en mode brut afin d'intercepter chaque touche sans attendre que vous validiez, pendant que le programme lit en continu ce qui arrive sur son entrée standard.
Et le rendu ne se limite pas à trois murs gris qui clignotent. On y trouve des sprites, des ennemis qui se baladent et vous tirent dessus, et même des secteurs de hauteur variable qui rapprochent l'ensemble du DOOM de 1993 plutôt que de son aîné Wolfenstein.
Le code complet est publié sur GitHub sous licence Apache, libre à chacun d'aller en fouiller les coulisses. Un internaute a d'ailleurs relevé que GnuCOBOL, le compilateur libre utilisé ici, sait parfaitement appeler du code écrit en langage C, ce qui ouvrirait l'accès à tout son arsenal de bibliothèques.
Toute la démonstration sert à rappeler que COBOL est Turing-complet, c'est-à-dire capable en théorie de calculer exactement la même chose que n'importe quel langage moderne, et à le prouver sur le terrain le plus hostile qu'on puisse lui opposer.
Bref, c'est rigoureusement inutile, et c'est très exactement pour ça que c'est cool.
Source : Hackaday
Avec la sortie de CUDA 13.3, NVIDIA renforce son écosystème GPU sur deux fronts importants. La version Python passe officiellement en 1.0 (donc considérée comme stable et utilisable en production), et CUDA Tile arrive nativement pour les développeurs C++.
Petit rappel pour les non-initiés : CUDA, c'est l'outil que tout le monde utilise pour faire tourner du calcul sur les cartes graphiques NVIDIA, principalement pour l'IA et le calcul scientifique.
Historiquement, c'est du C/C++ à 99%. NVIDIA pousse depuis quelques années pour rendre tout ça accessible en Python, et ce passage en 1.0 marque une étape importante. À partir de maintenant, l'API ne changera plus brutalement entre les versions mineures.
En pratique, les développeurs peuvent désormais compter dessus pour leurs projets long terme. La version 1.0 ajoute aussi le support des "green contexts" (un système pour réserver une partie de la GPU à des tâches isolées) et du checkpointing CUDA (la possibilité de sauvegarder l'état d'une exécution GPU pour la reprendre plus tard).
L'autre gros morceau, c'est CUDA Tile pour C++. Le modèle de programmation "tile" consiste à découper un calcul en blocs uniformes traités en parallèle, plutôt que de gérer chaque fil d'exécution individuellement (la GPU en fait tourner des milliers en même temps).
Il était déjà disponible en Python via des bibliothèques comme Triton. Il arrive maintenant en C++. L'idée est de monter d'un cran en abstraction : vous décrivez ce que vous voulez faire au niveau du bloc, et le compilateur s'occupe de mapper ça sur les threads. Le support couvre les GPU Hopper (l'architecture haut de gamme de NVIDIA pour les datacenters IA) et toutes les architectures plus récentes.
En bonus, NVIDIA introduit CompileIQ, un framework d'auto-tuning du compilateur qui promet jusqu'à 15% de gain sur des opérations critiques comme la multiplication de matrices ou les mécanismes d'attention utilisés dans les modèles d'IA. Le support du C++23 dans les compilateurs NVCC et NVRTC est aussi de la partie.
Pour les développeurs IA, c'est une nouvelle version importante. La programmation GPU est toujours un domaine très technique, mais NVIDIA réduit progressivement la barrière d'entrée, surtout côté Python. AMD a du boulot pour rattraper son retard avec ROCm, leur équivalent maison qui peine encore à convaincre la communauté.
Source : Phoronix
Alexander Petros, qui tient le blog Unplanned Obsolescence , a publié un tutoriel d'environ 3 500 mots qui explique les bases de Prolog, un langage de programmation logique des années 70 très différent des langages courants comme Python ou JavaScript, en utilisant les combats Pokémon comme support pédagogique. C'est étonnamment efficace.
Pour ceux qui n'ont jamais touché Prolog, la grosse différence avec un langage classique style Python ou JavaScript, c'est qu'au lieu de dire à l'ordinateur comment résoudre un problème étape par étape, vous lui décrivez les règles du jeu et vous le laissez chercher les réponses tout seul.
Vous écrivez des faits ("Bulbizarre est un Pokémon", "Bulbizarre est de type plante"), des règles ("un Pokémon vulnérable à X subit le double de dégâts d'une attaque de type X"), et vous posez ensuite des questions au système. Il fait le reste..
L'angle Pokémon est plutôt malin. Les combats Pokémon, c'est en fait un moteur de règles assez tordu : types, faiblesses, talents passifs, priorités d'attaques, statuts.
Bref, exactement le genre de domaine où Prolog brille et où un langage impératif transpire. Petros part de requêtes très simples ("est-ce que Carapuce est un Pokémon ?") et finit avec des filtres complexes qui sélectionnent les équipes en fonction de leur composition. À chaque étape, l'équivalent en SQL serait dix fois plus lourd.
Le passage le plus parlant, c'est quand il ajoute le support du talent Farceur, qui donne une priorité supérieure aux attaques de statut. Implémenter cette règle a pris trois minutes : il a ajouté une seule clause logique au programme.
Faites le même boulot dans un tableur ou une base SQL, et vous repartez pour des heures. C'est exactement le genre de cas où on comprend pourquoi Prolog a une niche stable, même si personne ne s'en sert au quotidien dans l'industrie.
Côté pédagogie, le choix est bon. La plupart des tutoriels Prolog vous balancent des relations familiales du style "Marie est la fille de Pierre, qui est le mari de...", ce qui marche mais reste relativement abstrait. Là, vous lisez le code et vous voyez immédiatement à quoi ça sert : à modéliser un combat Pokémon. Du coup les concepts d'unification, de prédicats et de négation passent presque tout seuls.
Si vous avez toujours voulu vous mettre à Prolog mais que les tutoriels classiques vous tombaient des mains, l'article de Petros est le point de départ qu'il vous faut.
Source : Hackaday
Des chercheurs en sécurité de Wiz ont découvert une vulnérabilité critique dans l'infrastructure interne de GitHub, permettant à n'importe quel utilisateur authentifié d'exécuter du code arbitraire sur les serveurs de la plateforme, le tout avec une seule commande git.
Vous avez déjà voulu créer une appli desktop qui tourne sur Linux, Mac et Windows en même temps ? En Rust, c'était un peu compliqué jusqu'ici. Heureusement, Slint , créé par la société allemande SixtyFPS GmbH, propose une solution sympa !
L'idée, c'est de décrire votre interface dans des petits fichiers .slint (un genre de mini HTML/CSS pour appli native), et de brancher ça à du Rust, du C++, du JavaScript ou du Python. Comme ça, vous codez le visuel d'un côté, la logique de l'autre.
Et ce qui est encore plus cool c'est que leur runtime tient dans 300 KiB de RAM. A titre de comparaison, une appli Electron type Discord en bouffe plusieurs centaines de mégaoctets. Slint tourne donc aussi bien sur un Raspberry Pi, un microcontrôleur STM32, ou directement dans un navigateur via WebAssembly.
Par exemple, SK Signet, un fabricant sud-coréen leader sur le marché américain des bornes de recharge électrique, anime ses écrans tactiles 15 à 32 pouces avec. OTIV fait tourner ses trains autonomes dessus. WesAudio l'utilise également pour son plugin audio pro.
Donc c'est du sérieux et si vous voulez tester sans rien installer, direction
SlintPad
. Vous tapez du code, et le rendu apparaît dans le navigateur. Ensuite pour débuter un projet Slint en local, faudra faire un cargo install slint-lsp puis utiliser le template slint-rust-template dispo sur GitHub. 2 minutes de compilation plus tard et hop, vous avez votre première fenêtre.
Côté tarif, Slint est gratuit pour les projets open source et gratuit aussi pour les applis desktop, mobile ou web même propriétaires. Seul l'embarqué propriétaire est payant. Donc pour la majorité des gens, c'est gratos.
Le revers de la médaille c'est qu'il faudra apprendre un nouveau langage de description, et la bibliothèque de boutons et menus prêts à l'emploi est moins fournie qu'un Qt qui a 30 ans d'avance derrière lui. Mais ça vaut le coup d'essayer puis vu que tout le monde vibe code de toute façon, ça ne devrait pas vous poser trop de soucis.
Voilà, si vous bricolez vos propres outils sur Raspberry Pi ou que vous voulez juste une appli desktop ultra-légère sans embarquer un navigateur entier avec, c'est à regarder.
Merci Chrltc pour le lien !
Source : github.com/slint-ui/slint
Le scraping web, c'est un combat permanent contre les sites qui changent leur HTML toutes les deux semaines. Vous vous emmerdez à coder vos sélecteurs CSS, ça marche pendant un mois, puis le site refait son design et hop, votre script s'eteint en silence. C'est pourquoi Karim Shoair (alias D4Vinci sur GitHub) a sorti Scrapling, un framework Python qui s'adapte tout seul quand le DOM bouge.
La clé c'est adaptive=True sur n'importe quel sélecteur. Vous lui dites "je cherchais .product", Scrapling sauvegarde alors la signature de l'élément (texte, attributs, position dans l'arbre), et la prochaine fois que le site a renommé sa classe, il retrouve l'élément via similarité.
Concrètement ça donne ça :
from scrapling.fetchers import StealthyFetcher
StealthyFetcher.adaptive = True
page = StealthyFetcher.fetch('https://example.com', headless=True)
product = page.css_first('.product', adaptive=True) # Retrouve l'élément même si la classe a changé
Le truc marche grâce à un algo de similarité maison qui compare la structure DOM autour de l'élément. L'auteur lui-même a écrit un long post Medium intitulé " Creating self-healing spiders with Scrapling in Python without AI ", et ça résume bien la philosophie : pas de modèle IA mais juste des heuristiques solides !
La doc précise que adaptive=True ne sauvegarde que le premier élément de la sélection. Du coup si vous récupérez 50 produits d'un coup avec .css('.product'), seul le premier sera adapté. Faudra donc soit utiliser css_first comme dans l'exemple, soit boucler manuellement et appeler adaptive sur chaque élément. C'est bon à savoir...
Y'a également 3 fetchers selon le besoin. Fetcher pour les requêtes HTTP rapides avec spoofing TLS, StealthyFetcher qui passe Cloudflare Turnstile via un navigateur furtif (Camoufox sous le capot), et DynamicFetcher qui lance un Chromium ou un Chrome via Playwright pour les sites lourds en JS. Du coup vous pouvez démarrer léger en HTTP et basculer vers un navigateur uniquement quand un site bloque, sans réécrire votre code.
Côté perfs, le README annonce du lourd : 2 ms pour extraire 5000 éléments contre 1584 ms pour BeautifulSoup avec lxml. Sauf que Parsel et Scrapy font aussi 2 ms. Donc le gain vient du moteur lxml utilisé en direct, ce qui veut dire que si vous étiez déjà sur Scrapy, vous ne gagnerez pas en vitesse brute. Mais si vous traînez encore du BS4 partout, le saut sera énorme !
Sur le terrain anti-bot, ça se compare bien à
Botasaurus
dont je vous avais parlé. La différence c'est que Scrapling embarque un ProxyRotator natif et propose un blocage d'ads/trackers (~3500 domaines) activable via block_ads=True ou automatique en mode MCP, ce qui simplifie la vie quand vous tournez sur un serveur (où les IPs des datacenter se font régulièrement filtrer). Botasaurus, lui, vous laisse gérer la rotation à la main.
Détail sympa pour les bidouilleurs : y'a également un serveur MCP est intégré (pip install "scrapling[ai]"). Du coup Claude ou Cursor peuvent piloter Scrapling directement pour extraire des données, en réduisant la consommation de tokens car l'IA ne voit pas tout le HTML brut, juste ce qui est extrait. Pour les agents qui scrappent en boucle, c'est cool.
Notez que les sponsors Platinum du projet sont tous des fournisseurs de proxies (DataImpulse, BirdProxies, Evomi, etc.). C'est logique vu l'usage du framework, mais gardez en tête que pour bypasser un Cloudflare sérieux à grande échelle, vous aurez besoin de proxies résidentiels payants, donc d'eux. L'outil est gratuit, mais le contournement industriel ne l'est pas.
Pour installer, c'est pip install "scrapling[fetchers]" puis scrapling install pour récupérer les binaires navigateur. Une image Docker existe aussi (pyd4vinci/scrapling) et y'a même un shell interactif (scrapling shell) pour debugger vos sélecteurs en live.
Bref, c'est carrément pas mal pour ceux qui scrapent régulièrement. Alors si BS4 vous fait pleurer, allez voir par ici .
Et merci à Letsar pour le lien !
Un dev français, Romain Laurent, vient de sortir un jeu qui transforme en divertissement TOUT ce que tous les devs fuient, à savoir l'astreinte de nuit, le téléphone qui sonne à 3h du matin, et le hotfix qu'il faut pondre vite fait avec une prod qui fume. Ça s'appelle Hotfix , ça tourne dans votre navigateur, et ça se prend au sérieux juste comme il faut, vous allez voir.
Dans ce jeu, vous enchaînez des micro-crises à résoudre le plus rapidement possible, sans filet. Vous commencez comme "Junior" à 0 points, parce qu'évidemment votre carrière de pompier recommence de zéro comme tout le monde puis ensuite ça monte en puissance. Il y a même un leaderboard, histoire que votre souffrance soit bien partagée à l'échelle mondiale. Le reste, c'est mieux que je ne le spoile pas, lancez une partie et découvrez ça vous-même !
En tout cas, Hotfix parle à une catégorie très précise de techos... Ça parle à ceux qui ont déjà reçu un ping PagerDuty pendant un apéro, à ceux qui ont tapé git push --force sur leur prod à 2h du matin ou encore à ceux qui ont commit "fix" sans savoir précisément ce qu'ils avaient fixé. Les autres joueront aussi, mais ils ne riront pas nerveusement de la même manière.
Bref, c'est à tester entre deux tickets ! Et classez-vous dans le leaderboard pour que je sois fier de ma commu ^^ (Ouais, je parle comme Tibo maintenant)
Ruby Central, l'association qui gère l'écosystème Ruby (RubyGems, Bundler, les conférences RubyConf et RailsConf), est en "vrai péril financier".
Le conseil d'administration l'a annoncé en se séparant de sa directrice exécutive, Shan Cureton, dans le cadre d'un plan de réduction des coûts. Les finances de l'organisation dépendaient trop "du timing optimiste de la réception des fonds par rapport aux dates fixes de nos dépenses", selon les administrateurs.
Le contexte, c'est un conflit qui dure depuis des mois. Fin 2025, Ruby Central a retiré plusieurs mainteneurs historiques de RubyGems et Bundler sans les prévenir.
Les mainteneurs concernés ont visiblement mal pris ce move, et ont lancé un fork rival appelé Gem Cooperative (gem.coop). Dans la foulée, ils ont publiquement accusé Ruby Central de prise de contrôle autoritaire. L'ancienne directrice avait en fait justifié les retraits par des demandes de sponsors et d'entreprises dépendantes de Ruby, inquiètes de problèmes de supply chain et de gestion des accès.
Le résultat, c'est un écosystème fracturé. D'un côté, Ruby Central avec le registre officiel RubyGems.org et les conférences. De l'autre, des mainteneurs expérimentés partis avec leur savoir-faire et une partie de la communauté. Et entre les deux, des sponsors qui hésitent à mettre de l'argent dans une organisation en crise de gouvernance.
Le conseil a voté en avril la transition vers un "working board" bénévole, ce qui veut dire moins de salariés et plus de travail non rémunéré. C'est le genre de restructuration qui peut effectivement sauver les finances à court terme, mais qui fatigue forcément les contributeurs au bout d'un moment.
Pour les développeurs Ruby, c'est quand même préoccupant. RubyGems est l'équivalent de npm pour JavaScript ou pip pour Python, c'est l'infra de base sur laquelle tournent des milliers de projets en production. Une association gestionnaire en péril financier et en conflit avec ses propres mainteneurs, ça fragilise clairement toute la chaîne.
Bref, Ruby Central doit trouver un modèle viable sans ses mainteneurs historiques et sans directrice. Pas simple.
Source : The Register
Wolfenstein 3D, pour ceux qui n'étaient pas nés en 1992, c'est le FPS qui a tout lancé. Le jeu de Carmack et sa bande chez id Software, qui a directement mené à DOOM l'année suivante.
Eh bien un dev Rust vient de le recréer de zéro, et c'est 100% jouable dans le navigateur.
Iron Wolf , c'est donc le projet de Michael Bohn, un allemand, qui bosse sur ce truc depuis mai 2021, soit près de cinq ans. On n'est donc pas sur un portage vibe codé à l'arrache. C'est vraiment une réécriture complète.
La version web d'Iron Wolf tournant dans le navigateur
Le bonhomme a carrément créé ses propres crates Rust pour émuler la carte VGA et la puce sonore OPL. J'ai d'abord cru qu'il réutilisait une lib existante, mais non, il a tout écrit from scratch en Rust. Bah ouais, développer ses propres librairies d'émulation hardware juste pour un side-project, what else ?? Je trouve que ça force le respect !
Le truc cool, c'est que la version shareware du jeu est incluse directement dans le dossier testdata/ du repo. Du coup sur macOS, Linux ou Windows, un git clone + just run-sdl-shareware et hop, vous voilà dans les couloirs du château. Attention sur Ubuntu 22.04, faut avoir libsdl2-dev d'installé avec apt install libsdl2-dev, sinon la compilation plante avec une erreur cryptique. Par contre, si vous êtes sur la version Ubuntu 24.04, là ça passe direct. Et si vous avez les fichiers WAD du jeu complet qui traînent sur un vieux CD-ROM quelque part, ce sera encore mieux car la version web permet de les uploader pour jouer à l'intégrale.
Ça tourne donc en WebAssembly sur wolf.ironmule.dev , sans plugin, juste Chrome ou Firefox récent. Voilà, si vous vous demandiez si on peut encore jouer au classique en 2026... la réponse est carrément oui !
Pour les curieux, le raycasting, cette technique de rendu qu'utilisait Wolfenstein 3D, est réimplémenté très fidèlement puisque le moteur de Michael dessine les murs comme le code de Carmack le faisait à l'époque... sauf que là ça tourne dans un onglet de navigateur. Vos fichiers de jeu sont également stockés localement via IndexedDB et un service worker gère le mode hors-ligne ce qui est très pratique pour jouer en avion ou quand on est chez Free (je décoooonnnne, humour humour).
Le projet en est à sa version 0.9.0, sous licence GPL-3.0 et si les classiques d'id Software recréés par des passionnés vous branchent, sachez que DOOM aussi a ses portages bien sympas.
Bref, si la nostalgie du raycasting vous titille, allez faire un tour sur wolf.ironmule.dev.
Pour recruter ses futurs ingénieurs, Anduril lance un défi hors norme : une course de drones 100 % autonomes. À la clé pour le meilleur codeur : 500 000 dollars et un poste dans l'entreprise de défense.
Pour recruter ses futurs ingénieurs, Anduril lance un défi hors norme : une course de drones 100 % autonomes. À la clé pour le meilleur codeur : 500 000 dollars et un poste dans l'entreprise de défense.
Mes notes succinctes à ce sujet :
Récupérer la bibliothèque ch554_sdcc : https://github.com/Blinkinlabs/ch554_sdcc (copie ci dessous si disparition du repo)
Récupérer l’outil de programmation ch552_tool : https://github.com/MarsTechHAN/ch552tool (copie ci dessous si disparition du repo)
Installer sdcc
$ apt-get install sdccCopier un exemple et l’utiliser comme base (le Makefile pointe vers un Makefile.include qui contient le nécessaire pour compiler vers le MCU cible).
Le MCU contient un bootloader USB, activé en connectant D+ au +5V à travers une résistance de 10kohms à la mise sous tension.
Utilisation de ch552tool :
$ sudo python3 ch55xtool/ch55xtool.py -f FIRMWARE.bin -rExecution en root nécessaire. Crash après la programmation si l’option « -r » (reset avec flash) est utilisée, à cause de la déconnexion du device cible.
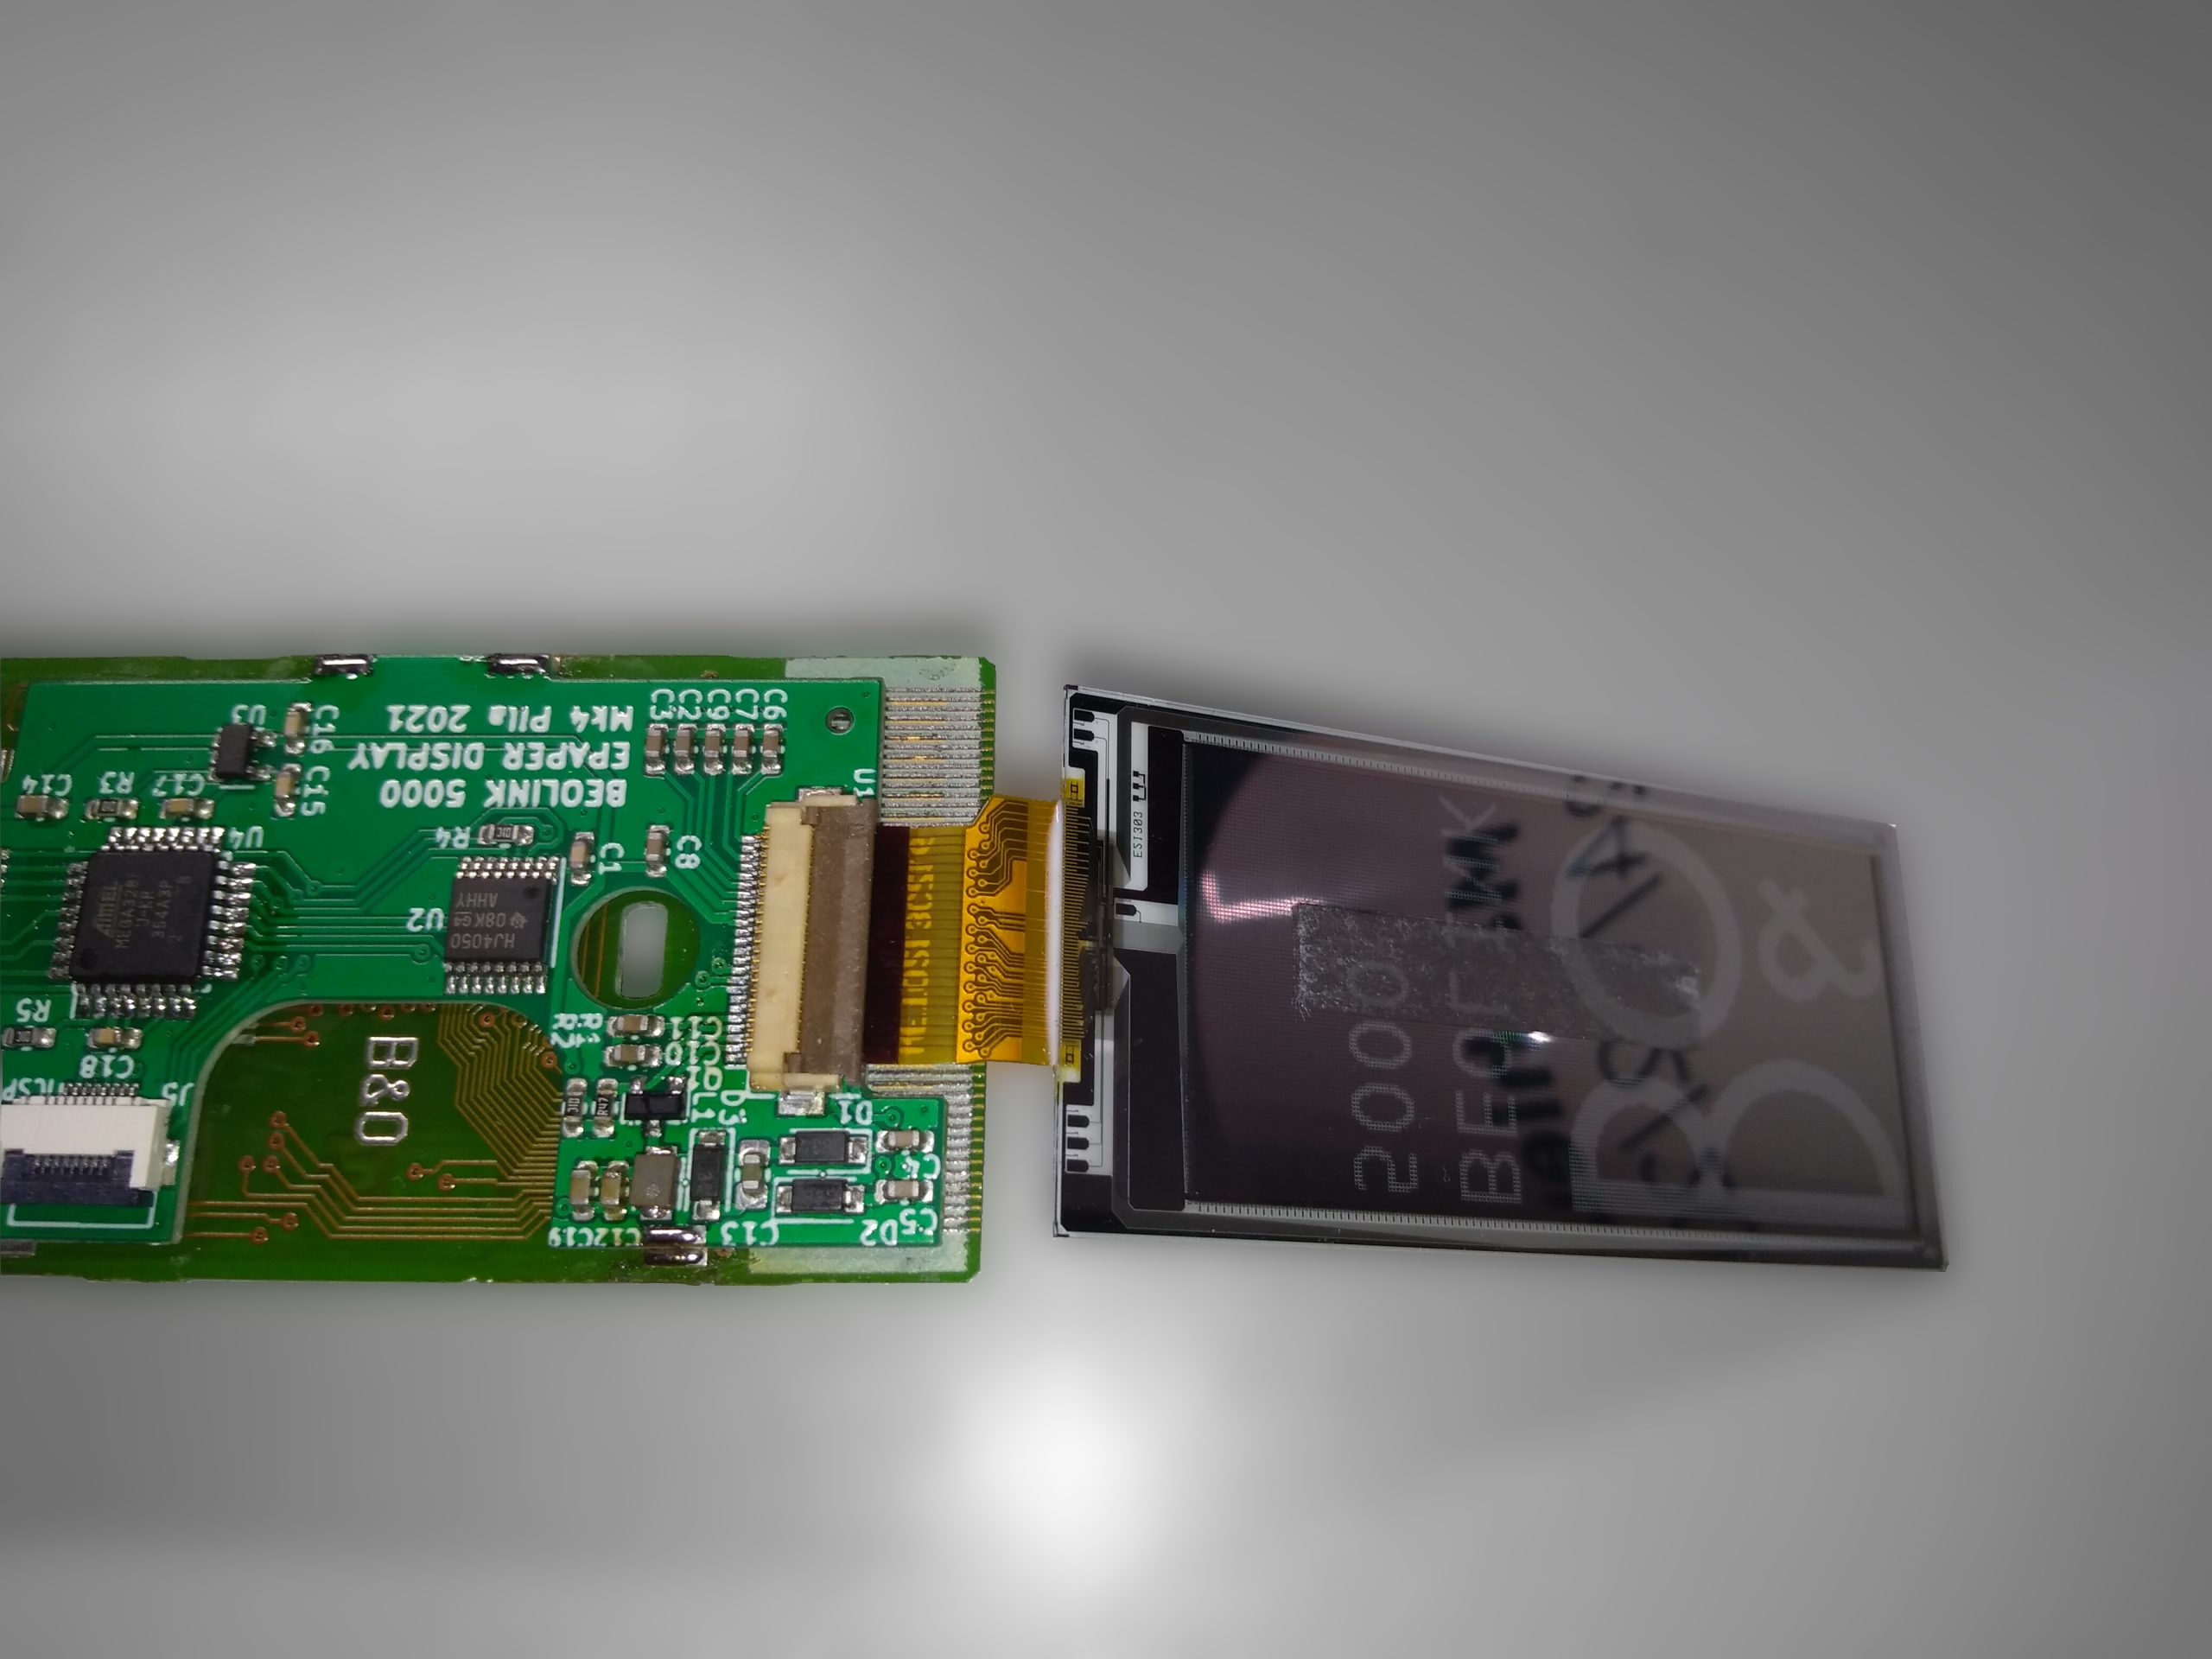
Produite entre 1991 et 1996 par le fabricant danois Bang & Olufsen, la Beolink 5000 est une télécommande permettant de contrôler les différents appareils de la marque, ainsi que de monitorer leur état grâce à l’écran LCD translucide présent à son extrémité. Ce modèle représentait en son temps l’état de l’art dans le domaine des télécommandes multimédia.
Malheureusement, bon nombre de ces télécommandes ont maintenant 30 ans d’age, et si certains composants vieillissants sont facilement remplacés ( notamment les condensateurs électrochimiques assurant la stabilité de la communication infrarouge ), les adhésifs chargés de maintenir en place l’écran et sa nappe montrent eux aussi des signes de faiblesse, avec pour conséquence un détachement partiel ou complet de la nappe de l’écran, ce dernier perdant de ce fait ses capacités d’affichage. La grande majorité des télécommandes encore existantes sont affectées par cette maladie. Certaines fonctions qui requièrent un écran fonctionnel, telles que le paramétrage de la télécommande, ou des équipements associés, deviennent alors inutilisables.
L’exemplaire en ma possession présentait un état encore plus dramatique, l’écran complètement séparé de la télécommande, la nappe le raccordant à son électronique de contrôle s’étant déchirée sous son poids. J’ai décidé de consacré une partie de mon temps libre de l’année dernière à la conception d’un remplacement.
L’écran LCD d’origine, translucide, et collé sur une plaque de verre trempé, est conçu spécialement pour cette usage, tout comme la nappe qui le relie à son contrôleur. Peu de chances de trouver un remplacement ou un équivalent, sans parler de l’équipement nécessaire au raccord de sa nappe. Ma recherche s’orientait initialement vers les afficheur OLED transparent, ayant dans l’idée d’ajouter une touche moderne à cette télécommande ( les afficheurs OLED étant capable d’émettre leur propre lumière, tandis qu’un afficheur LCD ne peut que la bloquer ). Si je n’ai pas pu identifier de modèle dont les dimensions permettraient son intégration en lieu et place de l’afficheur LCD d’origine, il existe un autre type d’afficheur qui accepte de se prêter à ce jeux : il s’agit d’un afficheur E-Paper.
Utilisés principalement dans les liseuses électroniques, les afficheurs E-Paper ont une apparence semblable à celle du papier, offrant un contraste inégalé, et la capacité de conserver leur affichage sans alimentation, au prix d’un temps de rafraîchissement particulièrement long, pouvant durer plusieurs secondes.
Ayant maintenant une solution possible, je me suis attelé à la conception d’un circuit capable de contrôler l’afficheur E-Paper, occupant le ( faible ) volume mécanique disponible dans la télécommande, et interprétant les commandes d’affichage transmises par le microprocesseur de la télécommande à la place du contrôleur LCD d’origine.
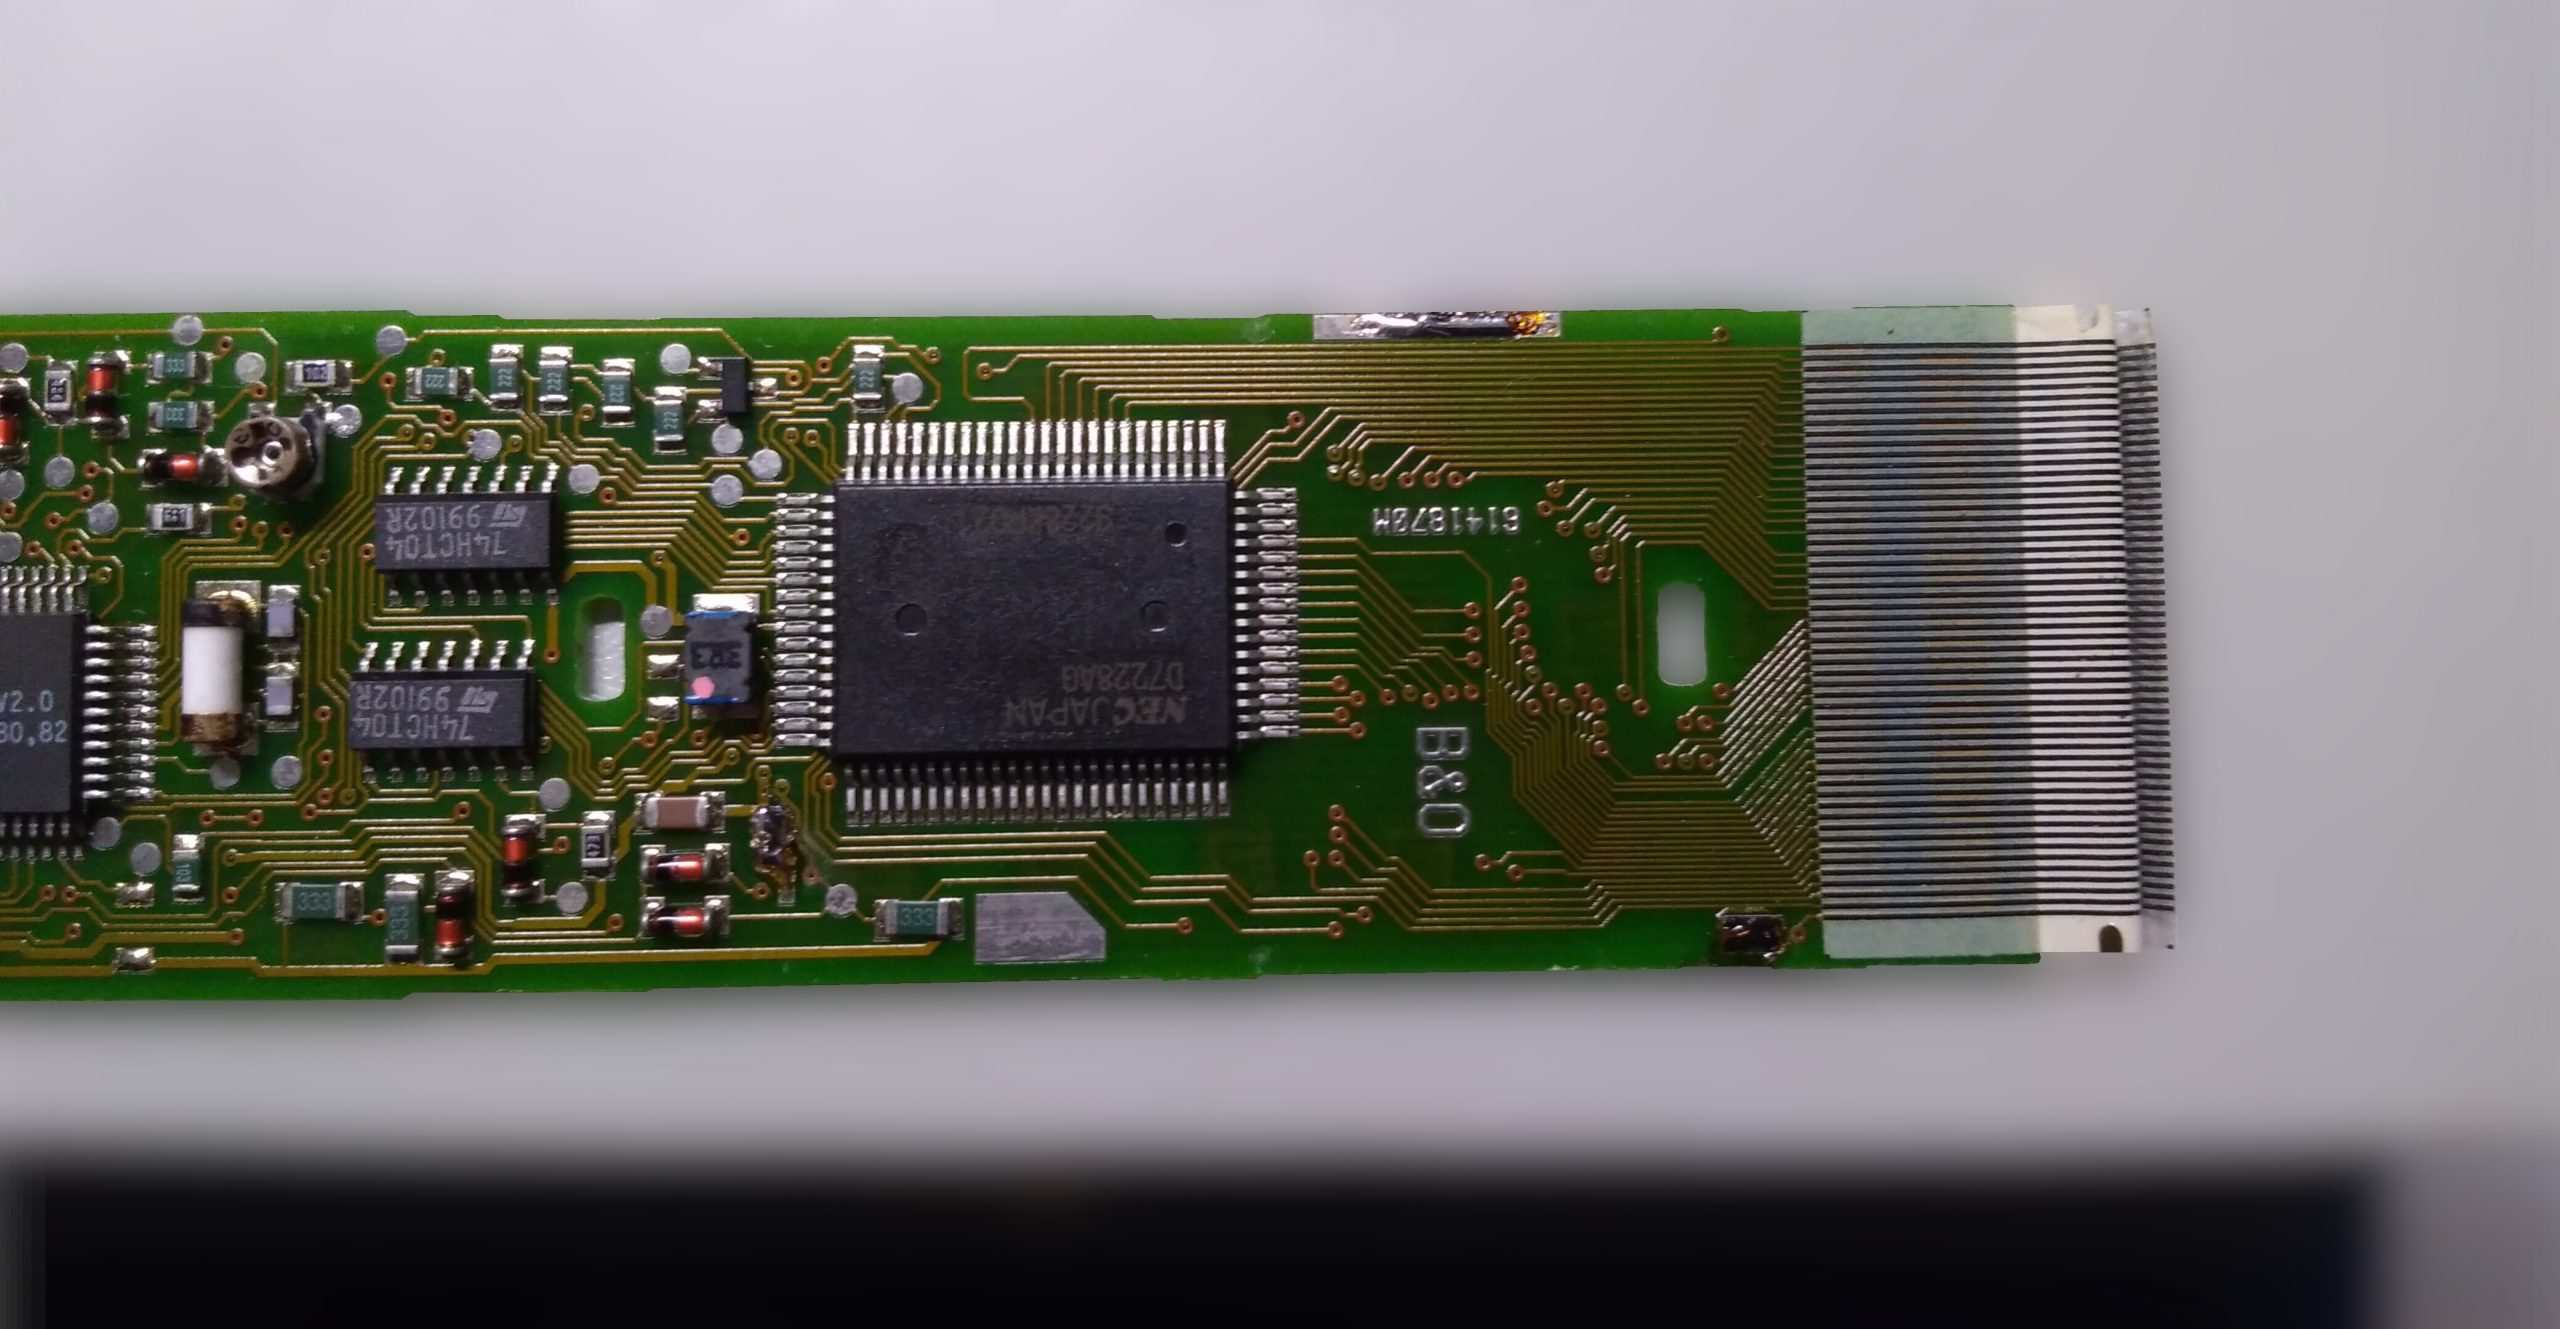
La tâche s’est avérée plus ardue que prévu, notamment car l’écran d’origine étant transparent, il est peut être lu d’un coté ou de l’autre en fonction du coté où sont situés les boutons en rapport avec la situation. Dans le cas d’un texte lisible par l’arrière, certains caractères ne sont pas transmis par le microprocesseur sous forme de texte, mais sous forme de bitmap, nécessitant la reconnaissance du caractère correspondant avant de pouvoir l’afficher. ( L’affichage direct des bitmaps n’est pas possible, la résolution de l’afficheur E-Paper n’étant pas un multiple de la résolution de l’afficheur d’origine ).
Le résultat est le suivant, et s’intègre directement dans la télécommande.
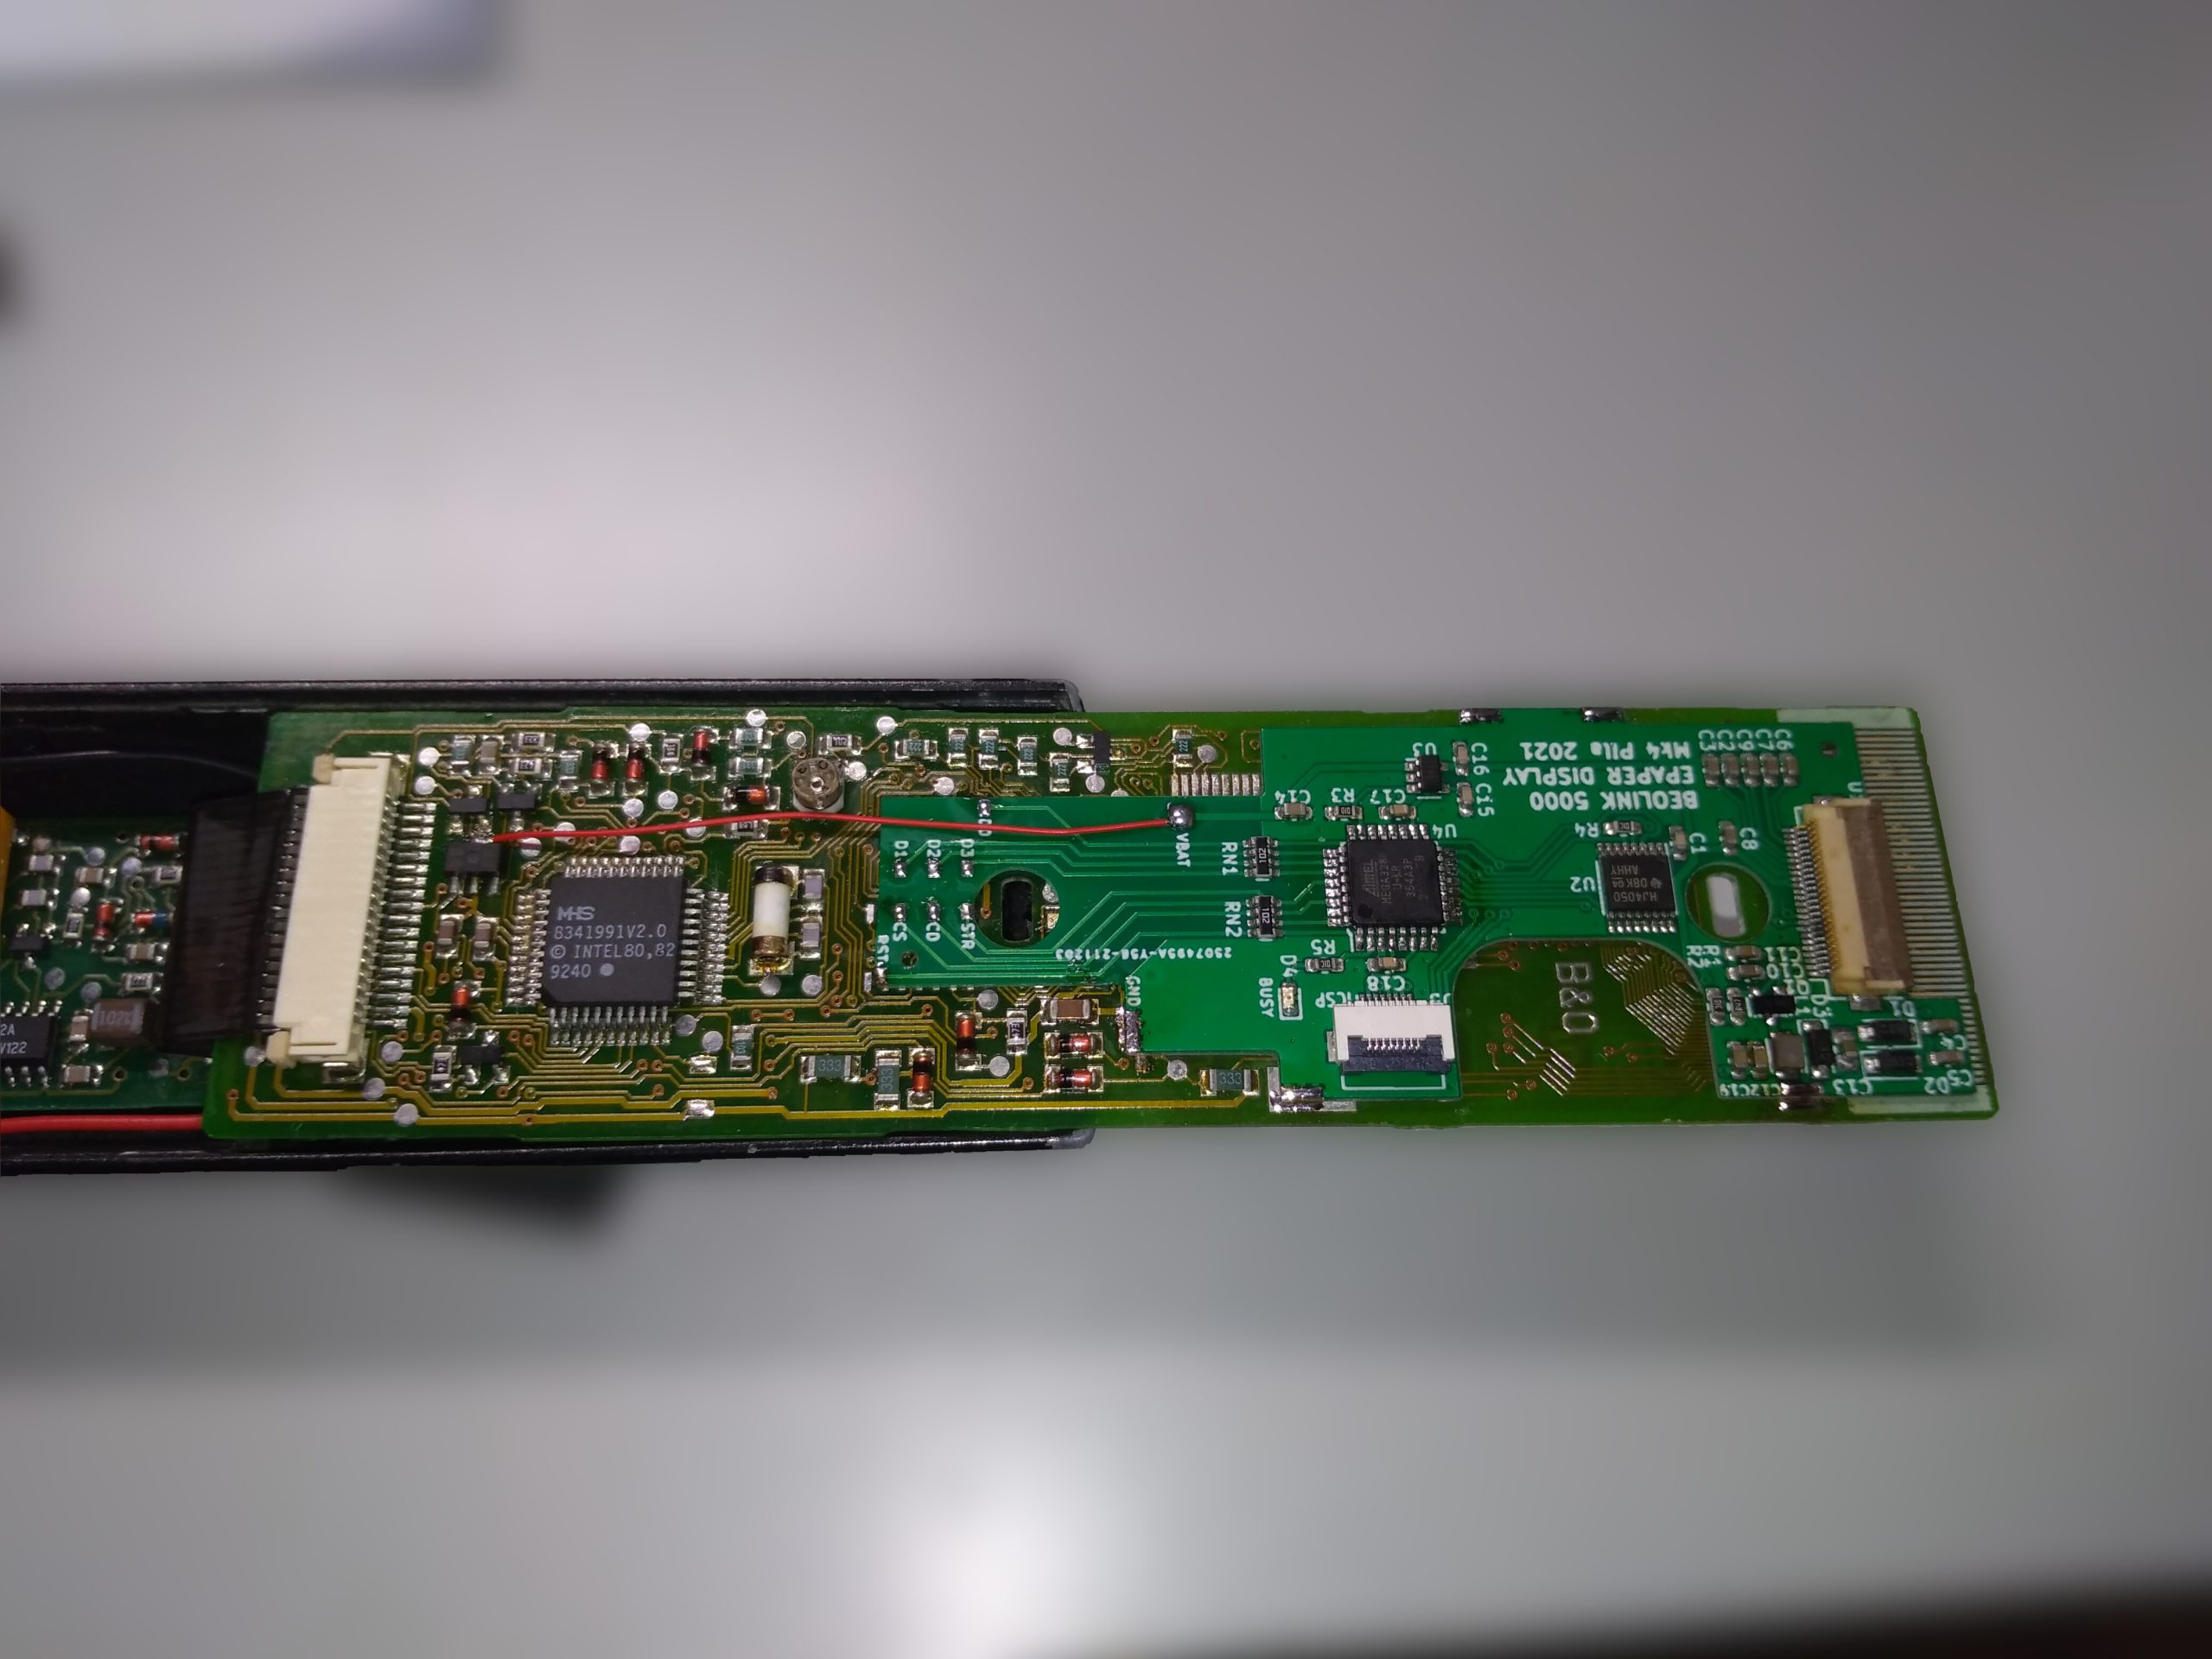
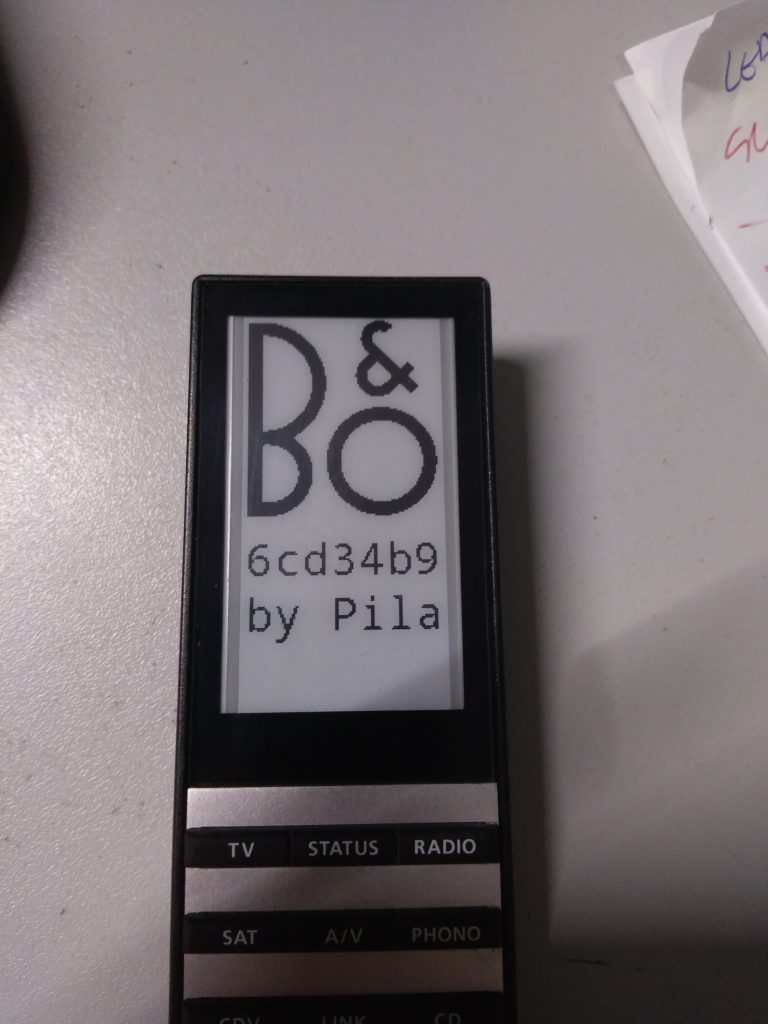
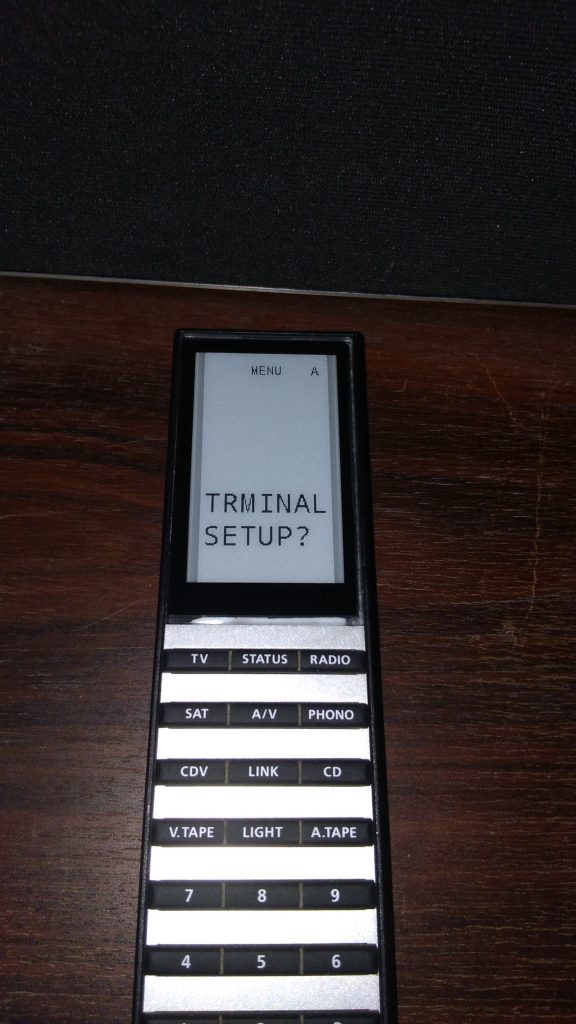

Fonctionnalités principales :
Le « clignotement » pendant le rafraîchissement, tel que visible sur la vidéo ci-jointe, est normal et inhérent à ce type d’afficheur.
Un guide d’installation en PDF est disponible ci dessous :
Un kit contient :
L’installation nécessite des compétences et de l’équipement de soudure électronique ( notamment une station de soudure, et une station à air chaud ), ainsi que de manipuler délicatement des pièces chaudes ( pour séparer la plaque de verre de l’écran )
Contactez moi pour acheter un kit. Je peux également réaliser l’installation sur votre télécommande.
Liens : Fil sur le Forum Beoworld ( anglais )
Par soucis d’exhaustivité, ci dessous des photos des premières itérations de PCB :
Si vous etes interessés, jetez aussi un oeil à BEOTOOTH 5500 : Un récepteur Bluetooth compatible Datalink
Cet article résume le process nécessaire pour compiler Marlin en ligne de commande sous Linux avec PlatformIO Core.
2. Ajouter PlatformIO au PATH local :
export PATH=$PATH:~/.platformio/penv/bin
3. Récupérer le code source de Marlin.
4. Si on récupère le code source officiel (et pas une version déjà customisée pour une machine spécifique ), récupérer les fichiers de configuration dans le dépot git MarlinFirmware/Configurations, et copier les fichiers de configuration adéquat dans le dossier Marlin / Marlin /
5. Se placer dans le dossier Marlin ( contenant platformio.ini ).
6. Identifier la valeur de MOTHERBOARD, en gras dans l’exemple ci dessous, à partir du fichier Configuration.h. ( pour une carte BTT SKR E3 MINI V2.0 )
$ cat Marlin/Configuration.h | grep MOTHERBOARD
 #ifndef MOTHERBOARD
     #define MOTHERBOARD BOARD_BTT_SKR_MINI_E3_V2_0
 If not defined the default pin for the selected MOTHERBOAR
7. Identifier les environnements PlatformIO compatibles à partir du fichier pins.h ( attention à supprimer le BOARD dans la valeur de MOTHERBOARD ):
$ cat Marlin/src/pins/pins.h | grep BTT_SKR_MINI_E3_V2_0
 elif MB(BTT_SKR_MINI_E3_V2_0)
    #include "stm32f1/pins_BTT_SKR_MINI_E3_V2_0.h"  // STM32F1
env:STM32F103RC_btt env:STM32F103RC_btt_512K
env:STM32F103RC_btt_USB env:STM32F103RC_btt_512K_USB
8. Compiler avec l’environnement adapté ( dans mon cas gestion de l’USB mais pas 512K de ROM ) :
$ platformio run -e STM32F103RC_btt_USB
9. Récupérer le fichier firmware.bin à l’emplacement suivant :
.pio/build/STM32F103RC_btt_USB/firmware.bin
10. Le copier sur une carte SD ( sans altérer son nom ), et la mise à jour s’effectue à la mise sous tension de l’imprimante. Le fichier sera alors renommé en FIRMWARE (sans extension).
11. Si présence d’un fichier EEPROM.DAT sur la carte SD lors de la mise à jour firmware, le contenu de l’EEPROM (calibration, réglages) sera écrasé.
Il s’agit d’un petit logiciel que j’ai développé sous Qt, facilitant la calibration d’un écran tactile / tablette graphique, notamment quand l’écran en question est un écran secondaire
Cet article décrit très rapidement la procédure que j’ai suivie ( durant de nombreuses heures de tatonnements ) afin de mettre en place sous Linux Mint un environnement de développement pour stm32f042 basé sur QtCreator, stm32plus et OpenOCD, permettant de s’affranchir des logiciels ST.
Cloner le dépot git situé à l’URL suivante :
https://github.com/andysworkshop/stm32plus
Installer les dépendances nécessaires :
$ apt install libnewlib-arm-none-eabi libstdc++-arm-none-eabi-newlib scons gdb-multiarch cmake
Compiler la bibliothèque stm32plus : Exécuter la commande suivante dans le dossier stm32plus en modifiant si nécessaire le type de MCU, le mode ( fast, small ou debug ) ainsi qu’en précisant la fréquence en Hz de l’oscillateur interne ou externe utilisé (paramètre hsi ou hse)
$ scons mode=debug mcu=f042 hsi=8000000 -j4
Installer la bibliothèque compilée :
$ sudo scons mode=debug mcu=f042 hsi=8000000 -j4 install
Corriger les problèmes de stm32plus avec CMake :
Dans le dossier /usr/local/arm-none-eabi/lib/stm32plus-040100
Pour éviter un problème de fichier non trouvé, éditer le contenu du fichier stm32plus-config.cmake pour ne conserver que les 2 premières lignes ( copiées ci dessous )
include(${CMAKE_CURRENT_LIST_DIR}/stm32plus-config-${STM32PLUS_CONFIGURATION}i.cmake

  OPTIONAL RESULT_VARIABLE STM32PLUS_CONFIG_FILE)
Modifier le fichier stm32plus-config-debug-f042-8000000i.cmake ( modification à répéter pour chaque version de stm32plus compilée ) : ajouter --specs=nosys.specs aux variables CMAKE_C_FLAGS et CMAKE_CXX_FLAGS.
Répéter éventuellement avec les autres modes pour disposer de la bibliothèque compilée pour chaque mode
Récupérer l’exemple de compilation avec CMake fourni avec stm32plus dans le dossier stm32plus/cmake/example
Dans QtCreator : Aide -> Plugins, activer « BareMetal », et redémarrer QtCreator
Dans les options de QtCreator, catégorie « Appareils Mobiles », onglet « Bare Metal », cliquer « Add » et sélectionner « OpenOCD », remplir ainsi :
Name : OpenOCD for STM32F042
Startup mode : Pipe mode
Executable file : openocd
Root script directory : /usr/share/openocd/scripts
Configuration file : /usr/share/openocd/scripts/board/st_nucleo_f0.cfg
Puis cliquer sur Appliquer
Dans les options de QtCreator, catégorie « Appareils Mobiles », onglet « Périphériques », cliquer « Ajouter » et sélectionner « Bare Metal Device », remplir ainsi :
Nom : STM32F042
GDB Service Provider : OpenOCD for STM32F042
Cliquer sur appliquer
Dans les options de QtCreator, catégorie « Kits », Onglet « Debugger », cliquer sur « Add » et remplir les champs suivants :
Name : GDB Multiarch
Path : /usr/bin/gdb-multiarch
Cliquer sur Appliquer
Dans les options de QtCreator, catégorie « Kits », Onglet « Kits », cliquer sur « Ajouter » et remplir les champs suivants :
Nom : STM32F042
Device type : Bare Metal Device
Device : STM32F042
Compiler C : GCC (C, arm 32 bits in /usr/bin)
Compiler C++ : GCC (C++, arm 32 bits in /usr/bin)
Debugger : GDB Multiarch
Qt Version : None
Cmake tool : System CMake at /usb/bin/cmake
CMake Configuration : cliquer sur « change », puis supprimer la ligne commençant par CMAKE_PREFIX_PATH
Cliquer sur appliquer
Se rendre dans le dossier où l’on a précédemment copié l’exemple CMake fourni avec stm32plus
Ouvrir le fichier CMakeList.txt avec QtCreator, et sélectionner le kit STM32 précédemment créé.
Editer le fichier CMakeList.txt pour refléter le MCU utilisé ainsi que le mode ( fast, small ou debug ) de compilation de stm32plus à utiliser. Spécifier aussi la fréquence de l’oscillateur, suivi de la lettre i ou e pour un oscillateur interne ou externe.
Dans mon cas, ce dossier était inexistant, j’ai copié le dossier system depuis l’example Blink ( sans CMake ), dans lequel j’ai renommé le dossier f042_48_8 en f042.
Renommer le fichier system/f042/startup.asm en system/f042/startup.s. Modifier le fichier CMakeList.txt pour refléter ce changement.
Dans la catégorie « Projet », sélectionner la variable CMAKE_PREFIX_PATH, et cliquer sur « unset », puis « Apply configuration change ». La variable doit se remplir avec le contenu suivant :
/usr/local/arm-none-eabi;/usr/arm-none-eabi
Dans QtCreator, Menu « Compiler », cliquer sur « Executer CMake ».
Il est maintenant (enfin) possible de compiler et de débugger le projet
En 2004, Sony commercialisait la PSP, une console de jeu portable qui, pour un tarif d’environ 200€, possédait des capacités de traitements ( graphiques notamment ) bien supérieures à celles de la concurrence.
Aujourd’hui, il est possible de s’en offrir une d’occasion en déboursant moins de 50€. J’ai donc décidé de m’y intéresser, non pas en temps que console de jeu, mais comme plateforme de développement.
Les sécurités de la console ayant été contournée assez rapidement, la scène du développement amateur a produit de nombreux Homebrew, ainsi que les outils permettant de développer sur la console sans acheter le ( très onéreux ) SDK officiel.
Cet article a pour vocation de résumer mon parcours quant à l’installation logicielle nécessaire.
La première étape consiste à se doter d’un émulateur capable d’exécuter du code PSP, permettant de valider le fonctionnement du code compilé.
Pour cela j’ai choisi PPSPP, donc le code source est disponible sur github. Les instructions de compilation sous Linux sont décrites ici.
Récupérer une copie du code source et de ses sous-modules
git clone https://github.com/hrydgard/ppsspp.git
git submodule update --init --recursive
Plusieurs front-end sont disponibles, j’ai choisi d’utiliser celui basé sur Qt, principalement pour ma familiarité avec ce framework. Installer les paquets nécessaires :
apt install qt5-qmake qtmultimedia5-dev qttools5-dev-tools qtmultimedia5-dev libqt5opengl5-dev
Lancer la compilation :
cd ppspp
./.sh --qt
Une fois la compilation terminée, l’exécutable se trouve dans le dossier build
Les scripts permettant l’installation de la toolchain se situent sur le dépot git ici : https://github.com/pspdev/psptoolchain
Les récupérer avec la commande suivante :
git clone https://github.com/pspdev/psptoolchain.git
Se placer dans le dossier ainsi créé :
cd psptoolchain
Exécuter ensuite le premier script, qui se charge de l’installation des dépendances pour Debian et ses dérivés ( Ubuntu et Linux Mint notamment ). Ce script va notamment remplacer le lien symbolique /bin/sh pointant vers le logiciel DASH, par un nouveau lien symbolique pointant vers BASH, DASH ne permettant pas de mener l’installation de la toolchain sans erreurs.
./prepare-debian-ubuntu.sh
Ensuite, exécuter le script d’installation à proprement parler. Celui ci nécessite les droits super utilisateurs, d’où sont appel avec la commande sudo
sudo ./toolchain-sudo.sh
L’installation se déroule ensuite normalement. Sur ma machine, plutôt véloce, celle-ci a duré une bonne demi-heure.
L’installation va déposer les fichiers nécessaires dans le répertoire /usr/local/pspdev, et automatiquement modifier les variables d’environnement pour permettre l’appel des bons exécutables lors de la compilation, en modifiant notamment la variable d’environnement PATH. Ce système ne me plaisant guère ( pour des raisons décrites dans l’article précédent ), je vais déplacer l’ensemble de la toolchain dans un dossier séparer, empêcher la modification du PATH, et ajouter un petit script permettant le fonctionnement de la toolchain seulement dans le terminal où il sera appelé.
Déplacer la toolchain dans mon home, et en devenir propriétaire :
sudo mv /usr/local/pspdev ~/

sudo chown -R MON_NOM_DUTILISATEUR ~/pspdev/
Empêcher la modification automatique du PATH au démarrage :
sudo rm /etc/profile.d/psptoolchain.sh
Créer le script permettant de configurer un terminal capable d’utiliser la toolchain :
nano ~/pspdev/setupPspEnv.sh
Y insérer le contenu suivant :
#!/bin/bash
bash --rcfile <(cat ~/.bashrc; echo 'PS1="\e[33;1mpspdev \$\e[0m "' ; echo 'export PATH="#/pspdev/bin:$PATH"' ; echo 'export PSPDEV="~/pspdev/"')
Il suffit ensuite d’exécuter ce fichier pour mettre un place, uniquement dans le terminal actif, les variables d’environnement nécessaires au fonctionnement de la toolchain.
La toolchain contient PSPSDK. Il s’agit d’un SDK amateur qui fournissant toutes les fonctions nécessaires aux développement d’une application sur PSP. De nombreux exemples sont disponibles dans le dossier pdpdev/psp/sdk/samples.
Malheureusement, beaucoup ne compilent pas correctement. La commande make produit bien un exécutable EBOOT.PBP lisible par ppspp, mais ceux-ci provoquent souvant le crash de l’émulateur, sans plus d’information qu’un laconique « segmentation fault ».
Il s’avère que la LIBC utilisée normalement par le compilateur GCC ne produit pas du code valide en ce qui concerne le traitement des nombres flottant. Il suffit d’ajouter une ligne au Makefile de chaque example ( et plus tard aux Makefile de nos propres projets ) :
...
PSP_EBOOT_TITLE = Reflection Sample
USE_PSPSDK_LIBC = 1
PSPSDK=$(shell psp-config --pspsdk-path
...
Cette ligne spécifie au compilateur d’utiliser la LIBC fournie avec PSPSDK, et non celle fournie avec GCC.
j’ai finalement pu compiler les exemples ( notamment ceux liés à l’unité graphique (GU) de la console, afin de ma familiariser avec sa programmation, comme l’atteste le screenshot suivant :
Cet article n’est que le premier pas d’un projet centré autour d’une PSP, qui fera l’objet d’un futur article. En attendant, j’espère que celui-ci vous épargnera les nombreux tâtonnements qui m’ont été nécessaires pour en arriver là !
Attention : valable uniquement pour les versions de ESP-IDF non basées sur CMAKE ( versions < 4.0 )
Travaillant actuellement sur un projet nécessitant une interface audio en bluetooth, je me suis tourné vers la solution la plus en vogue, l’ESP32.
Embarquant Wifi, Bluetooth (dont BLE), un CPU dual core avec 4 Mo de Flash, mais également très abordable, il dispose également d’un SDK entièrement open-source, très bien documenté !
La procédure d’installation de ce SDK nécessitant de modifier certaines variables d’environnement ( en particulier la variable PATH ), et n’aimant pas modifier des éléments aussi critiques du système ( il est possible en modifier de PATH de remplacer certaines commandes du système à l’insu de l’utilisateur ! ), j’ai donc, avant toute expérimentation avec l’ESP32, pris le temps d’écrire un petit script bash.
Ce script permet de démarrer un nouvel interpréteur BASH contenant les variables d’environnements permettant le bon fonctionnement du SDK ESP32, sans affecter les variables d’environnement utilisées par tous les autres terminaux du système. De plus, il possède un prompt de commande personnalisé, afin de distinguer rapidement le terminal utilisé pour le SDK.
Son contenu, succin, est le suivant :
!/bin/bash
 bash --rcfile <(cat ~/.bashrc; echo 'PS1="\e[33;1mesp32 \$\e[0m "' ; echo 'export PATH="$HOME/esp32/xtensa-esp32-elf/bin:$PATH"' ; echo 'export IDF_PATH="$HOME/esp32/esp-idf"')
Attention : il est supposé que l’ensemble des fichiers nécessaires au SDK se trouvent dans le dossier ~/esp32. Si ce n’est pas le cas, modifier les chemins en conséquence
Il suffit d’exécuter le script pour obtenir un interpréteur BASH adéquat, et de quitter l’interpréteur (commande »exit », ou CTRL+D) pour revenir à un terminal normal.
J’ai testé son fonctionnement quelques heures, et en suis tout à fait satisfait. N’hésitez pas à me communiquer tout bug, ou amélioration possible !
Mon hackerspace local disposant depuis peu d'une fraiseuse à commande numérique pour la gravure de PCB, j'ai beaucoup joué avec.
La machine (low cost, mais robuste) est dotée d'un firmware libre dédié au contrôle de CNC par un hardware basé sur Arduino : Grbl
Plusieurs interfaces utilisateurs (pour PC) existent déjà pour Grbl. Cependant, aucune d'entre elles ne semble permettre la gestion automatisée de plusieurs tâches, ni n'offre d'interface optimisée pour un écran tactile. Ce sont là 2 des objectifs de ce projet.
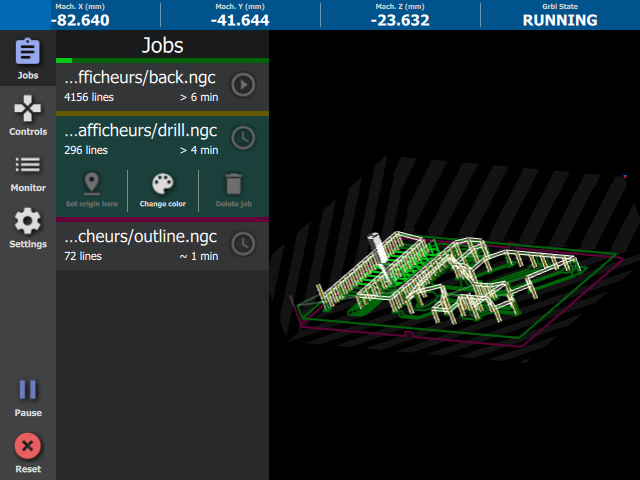
Capture d'écran avec le panneau "Jobs" déployé
Ses principaux atouts sont :
Le point le plus intéressant, et qui fut même le point d'origine de ce projet, réside dans sa compatibilité avec les plateforme Android.
En effet, les tablettes Android représentent, par leur faible consommation, leur faible encombrement, et leur utilisation intuitive, une plateforme idéale pour une interface utilisateur.
Le support Android, à l'état de preuve de concept, est toujours en développement. Si l'application démarre sur la grande majorité des périphérique, une version d'Android >= 3.1 et compilée avec le support USB Host est nécessaire pour s'interfacer avec la fraiseuse à travers un convertisseur USB / UART.
Le code source de Grbl Overseer et les instructions de compilation pour Linux sont disponibles sur Gitlab : >> ICI <<
Une archive contenant l'exécutable pour MS Windows est disponible >> LA <<
De nombreux bug subsistent encore, notamment dans la gestion particulière de l'USB et du rendu Open GL ES propre à Android.
Sur PC en revanche, le logiciel devrait se montrer stable, n'hésitez pas à l'essayer, et à me faire remonter vos remarques !


 Lateo.net - Flux RSS en pagaille (pour en ajouter : @ moi)
